
claude-smart 插件:CC/Codex 自我学习插件,把纠正变成下次会遵守的规则
用过一段时间 Claude Code 的开发者大概都遇到过同一种烦躁——这个项目用的是 pnpm 不是 npm,上周已经说过;npm test 在这个仓库里默认是 watch 模式会卡住 CI,要加 --run,上周也说过。每开一个新 session,这些纠正都要重来一遍。claude-smart 是 Reflexio 团队推出的 Claude Code 与 Codex 双 host 插件,目标是把这些纠正变成下一次会真的被遵守的规则。它通过 lifecycle hooks 自动捕获每轮对话、工具调用和助手回复,提炼成结构化规则,并在每个新 session 启动时注入回 Claude Code 或 Codex 的系统提示。

整个流程跑在本地——语义搜索用本地 ONNX embedder(all-MiniLM-L6-v2,约 86 MB),数据存在 ~/.reflexio/ 与 ~/.claude-smart/,没有外部 API 调用。
它在解决什么问题
现有的“AI 记忆”方案大多是在新 session 里重新注入旧 session 的对话摘要或转录——Claude 记得发生过什么,但不一定会改变下一次的行为。Reflexio 在 README 中划清了这道分界线:claude-smart 关注的不是“记忆”而是“学习”。两者的差别在 README 里给了一个具体例子:
- 记忆:“部署在 Claude 把 prisma 从 5.x 升到 6.0 后失败,用户回滚了”——只是信息
- 学习:“把 ORM / DB driver 的主版本升级视为破坏性变更——用集成测试而非仅单元测试验证”——是可执行的规则
后者的差别在于它不是描述过去,而是给出“下次该怎么做”的明确指令。同样的逻辑适用于成功的工具调用序列——“在这个仓库里始终用 pnpm dev:all 启动完整本地栈,npm run dev 只会启动前端”——这种“配方”会被记录下来供下次复用。
关键差异化在于结构化与持久化——claude-smart 产出的不是几千 token 的对话摘要,而是几十 token 的去重规则;不是 session 内的临时上下文,而是跨 session 累积的项目知识。据 Reflexio 自己的对比测试,相对于 claude-mem,claude-smart “把纠正变规则”的成功率约高 3 倍、用户引导的留存率约高 50%(该数据由项目方自评,未见第三方独立复现)。
三个产物:Preferences、Project-specific Skills、Shared Skills
据官方说明,claude-smart 会持续生成三份独立的产物,并在新 session 启动时按相关性匹配注入:
Preferences(偏好,项目范围)——你在这个仓库里的工作方式与小怪癖。例如“用 pnpm 不用 npm”“偏好简洁回答”“后端工程师,希望前端概念用后端类比解释”。偏好被严格限定在当前项目,不会泄漏到其他仓库。
Project-specific Skills(项目专属技能)——从单个项目的纠正中累积的、带触发条件和理由的规则。例如“npm test 始终加 –run——watch 模式会阻塞 CI”。每条规则都包含:何时适用、为什么这么做、具体做什么。
Shared Skills(共享技能)——从多个项目的规则中提炼、应该跨项目复用的优化模式。例如“集成测试用真实 Postgres,不用 mocks——mocks 曾经掩盖过一次损坏的迁移”。这一层把“对所有项目都成立”的规律与“只对这个项目成立”的规律分开存。
规则不是堆积,是持续自调优
claude-smart 的规则维护机制不是简单的“冲突时追加”——而是持续重写。Reflexio 文档明确列出了四种动作:
- 措辞改进——同一条规则的描述会随证据积累变得更清晰
- 触发条件调整——适用范围会随新证据收紧或放宽。例如 “npm test –run” 规则在 vitest 也适用后,触发条件会自动放宽
- 近似重复合并——同一件事被纠正两次会合并成一条
- 归档过时规则——你改变政策(如从 npm 切到 pnpm),旧规则会被归档,新规则取代它
这意味着规则库不会随项目变大而臃肿——Reflexio 官方称即使项目持续增长,规则总量也能维持在几十个 token 而非几千个的量级。
双 host、共享数据、本地仪表盘
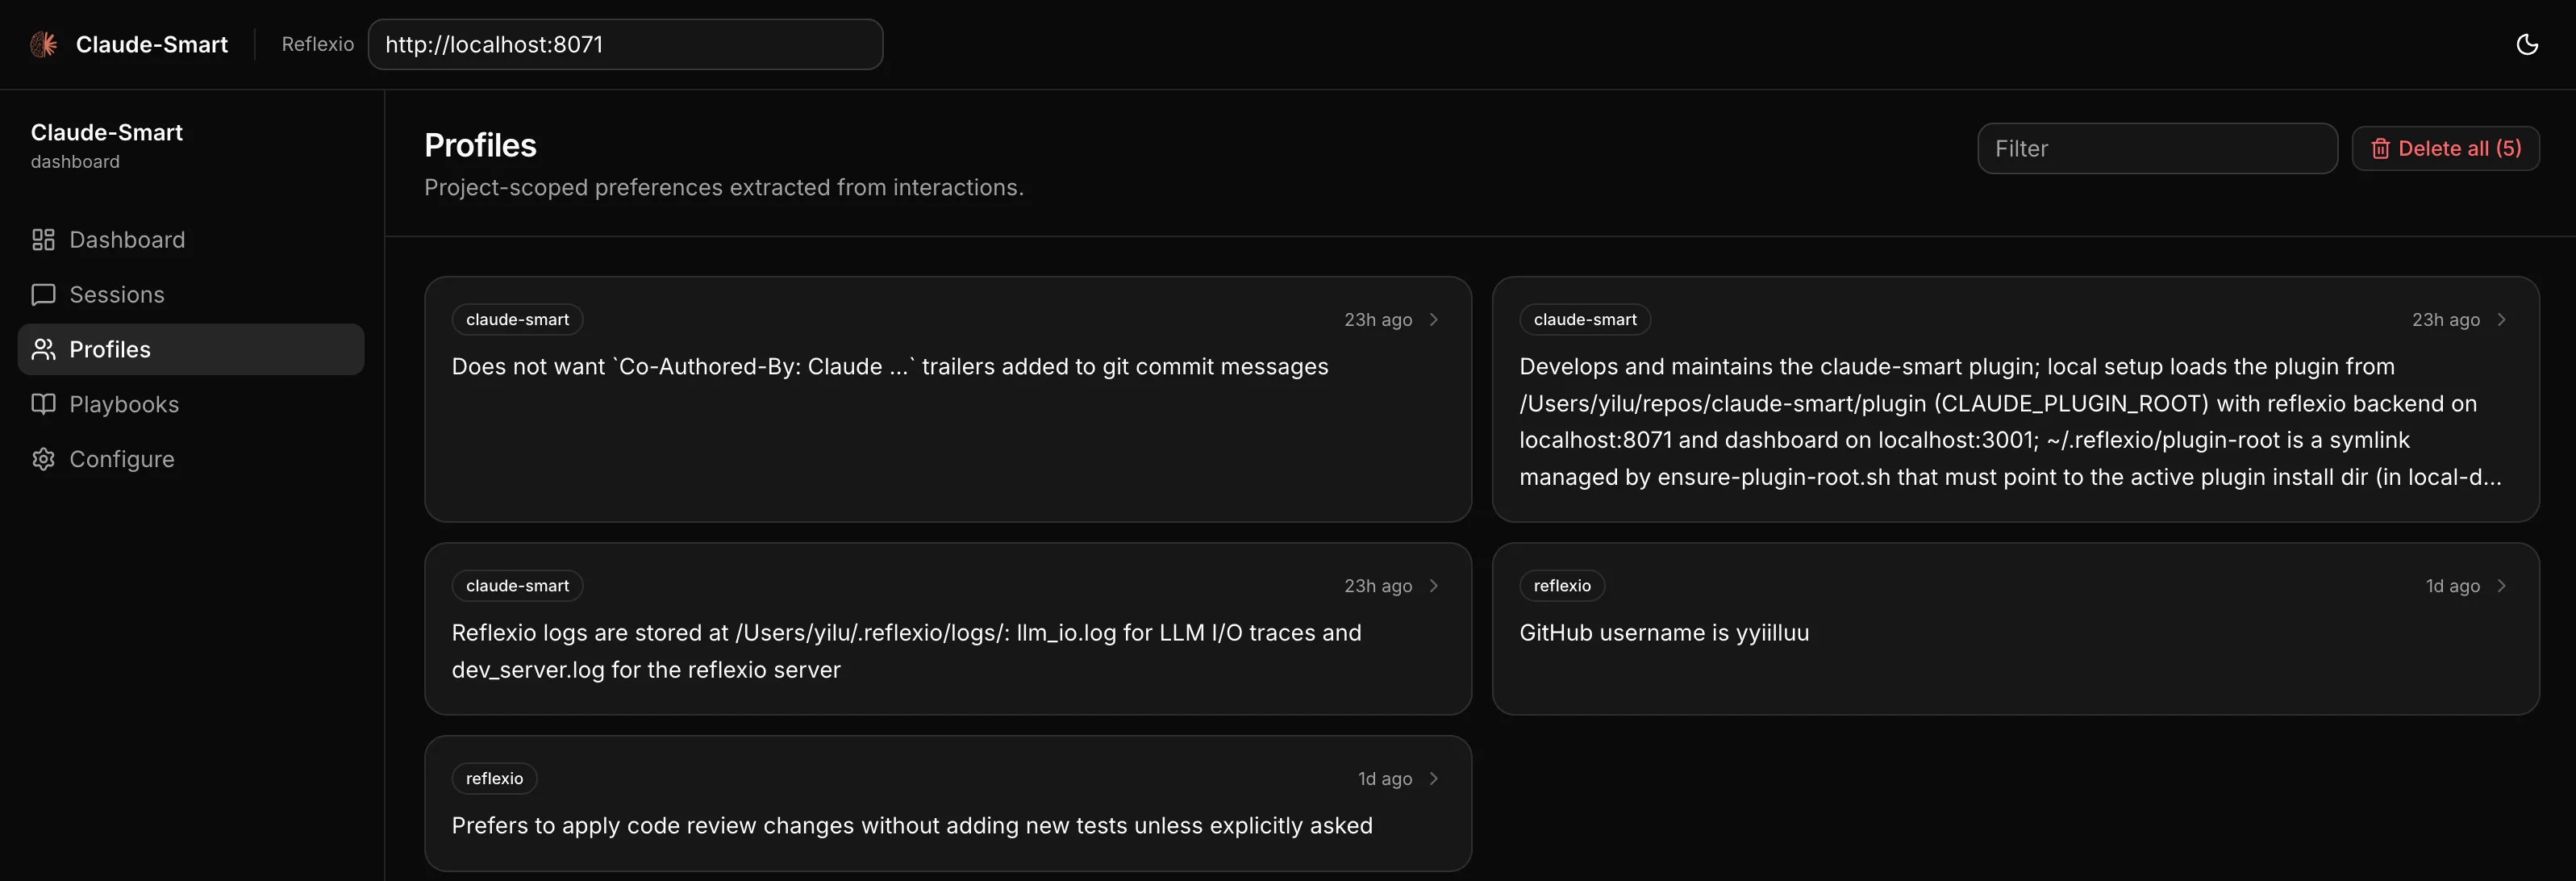
claude-smart 同时支持 Claude Code 与 Codex 两个 host,且两边共享同一份学习数据——Codex 上累积的规则在 Claude Code 上也能用,反之亦然。
它还自带一个本地仪表盘(http://localhost:3001),用来浏览 session 历史、检查 Preferences、编辑 Skills。在 Claude Code 里跑 /claude-smart:dashboard 就能打开。其他常用的 slash 命令包括:
/claude-smart:show——打印当前项目的所有规则与偏好/claude-smart:learn——把上一轮标记为“重要纠正”,提取器会立刻处理/claude-smart:clear-all——清空所有学习数据,从头开始
助手回复末尾偶尔会出现一个标记,比如 ✨ 2 claude-smart learnings applied [cs:s1-252,p1-5aed]——意思是这一轮回复有 2 条已学规则在起作用,s 是 skill、p 是 preference。点开仪表盘的 session 详情页能看到具体引用了哪些条目。这是 claude-smart 提供的可审计能力,让“AI 凭什么这么回答”变得可追溯。
怎么上手
Claude Code 安装一行命令:
npx claude-smart install
然后重启 Claude Code 即可。Codex 用户加一个参数:
npx claude-smart install --host codex
也可通过 Claude Code 自带的插件市场安装:claude plugin marketplace add ReflexioAI/claude-smart,再 claude plugin install claude-smart@reflexioai。
平台支持需要注意——Apple Silicon Mac(macOS 14+)、Windows x64、Linux 都支持;Intel Mac、macOS 13 及以下、Windows ARM 暂不支持(本地嵌入模型的 native wheel 在这些平台上不完整)。首次安装需要联网下载约 86 MB 的 ONNX 模型。
真正需要记住的是
claude-smart 解决的是 Claude Code 与 Codex 长期使用中一个真实却容易被忽视的痛点——session 隔离让纠正无法沉淀。每次开新对话都从零开始解释项目惯例,浪费的不只是时间,也是“AI 应该越用越懂这个项目”的预期。把纠正变规则、把成功路径变配方、跨 session 累积,并通过 Shared Skills 实现跨项目复用——这是一种自然的解法。
需要 cool down 的部分也清楚——3 倍优于 claude-mem 的数据由 Reflexio 自评,第三方独立复现尚未出现;规则质量与“误学习”(把错误纠正也固化成规则)问题需要长期使用验证;Intel Mac 用户与较旧 macOS 用户目前用不了;首次安装需要联网拉模型,对中国大陆网络环境的用户可能需要配代理。
适合的人群——已经在用 Claude Code 或 Codex 做长期项目、对同一个仓库反复发起多轮 session 的开发者;如果你的工作流稳定每周开十几个 session,每次都要重复几条项目惯例,这个插件值得放进默认配置。不适合做一次性脚本或快速 prototype 的场景——没有“积累规则”的需求,装它的收益不大。
评论 0