
Claude Opus 5 发布:代码能力达 SOTA,成本减半逼近 Fable 5
Anthropic 正式发布 Claude Opus 5,该模型在保持与 Opus 4.8 相同定价的同时,在代码编写与知识工作能力上达到了新高度,部分指标接近顶级模型 Claude Fable 5。据 Anthropic 官方博文,Claude Opus 5 已成为 Claude Max 的默认模型以及 Claude Pro 平台上的最强模型。

代码与知识工作能力实现 SOTA 突破
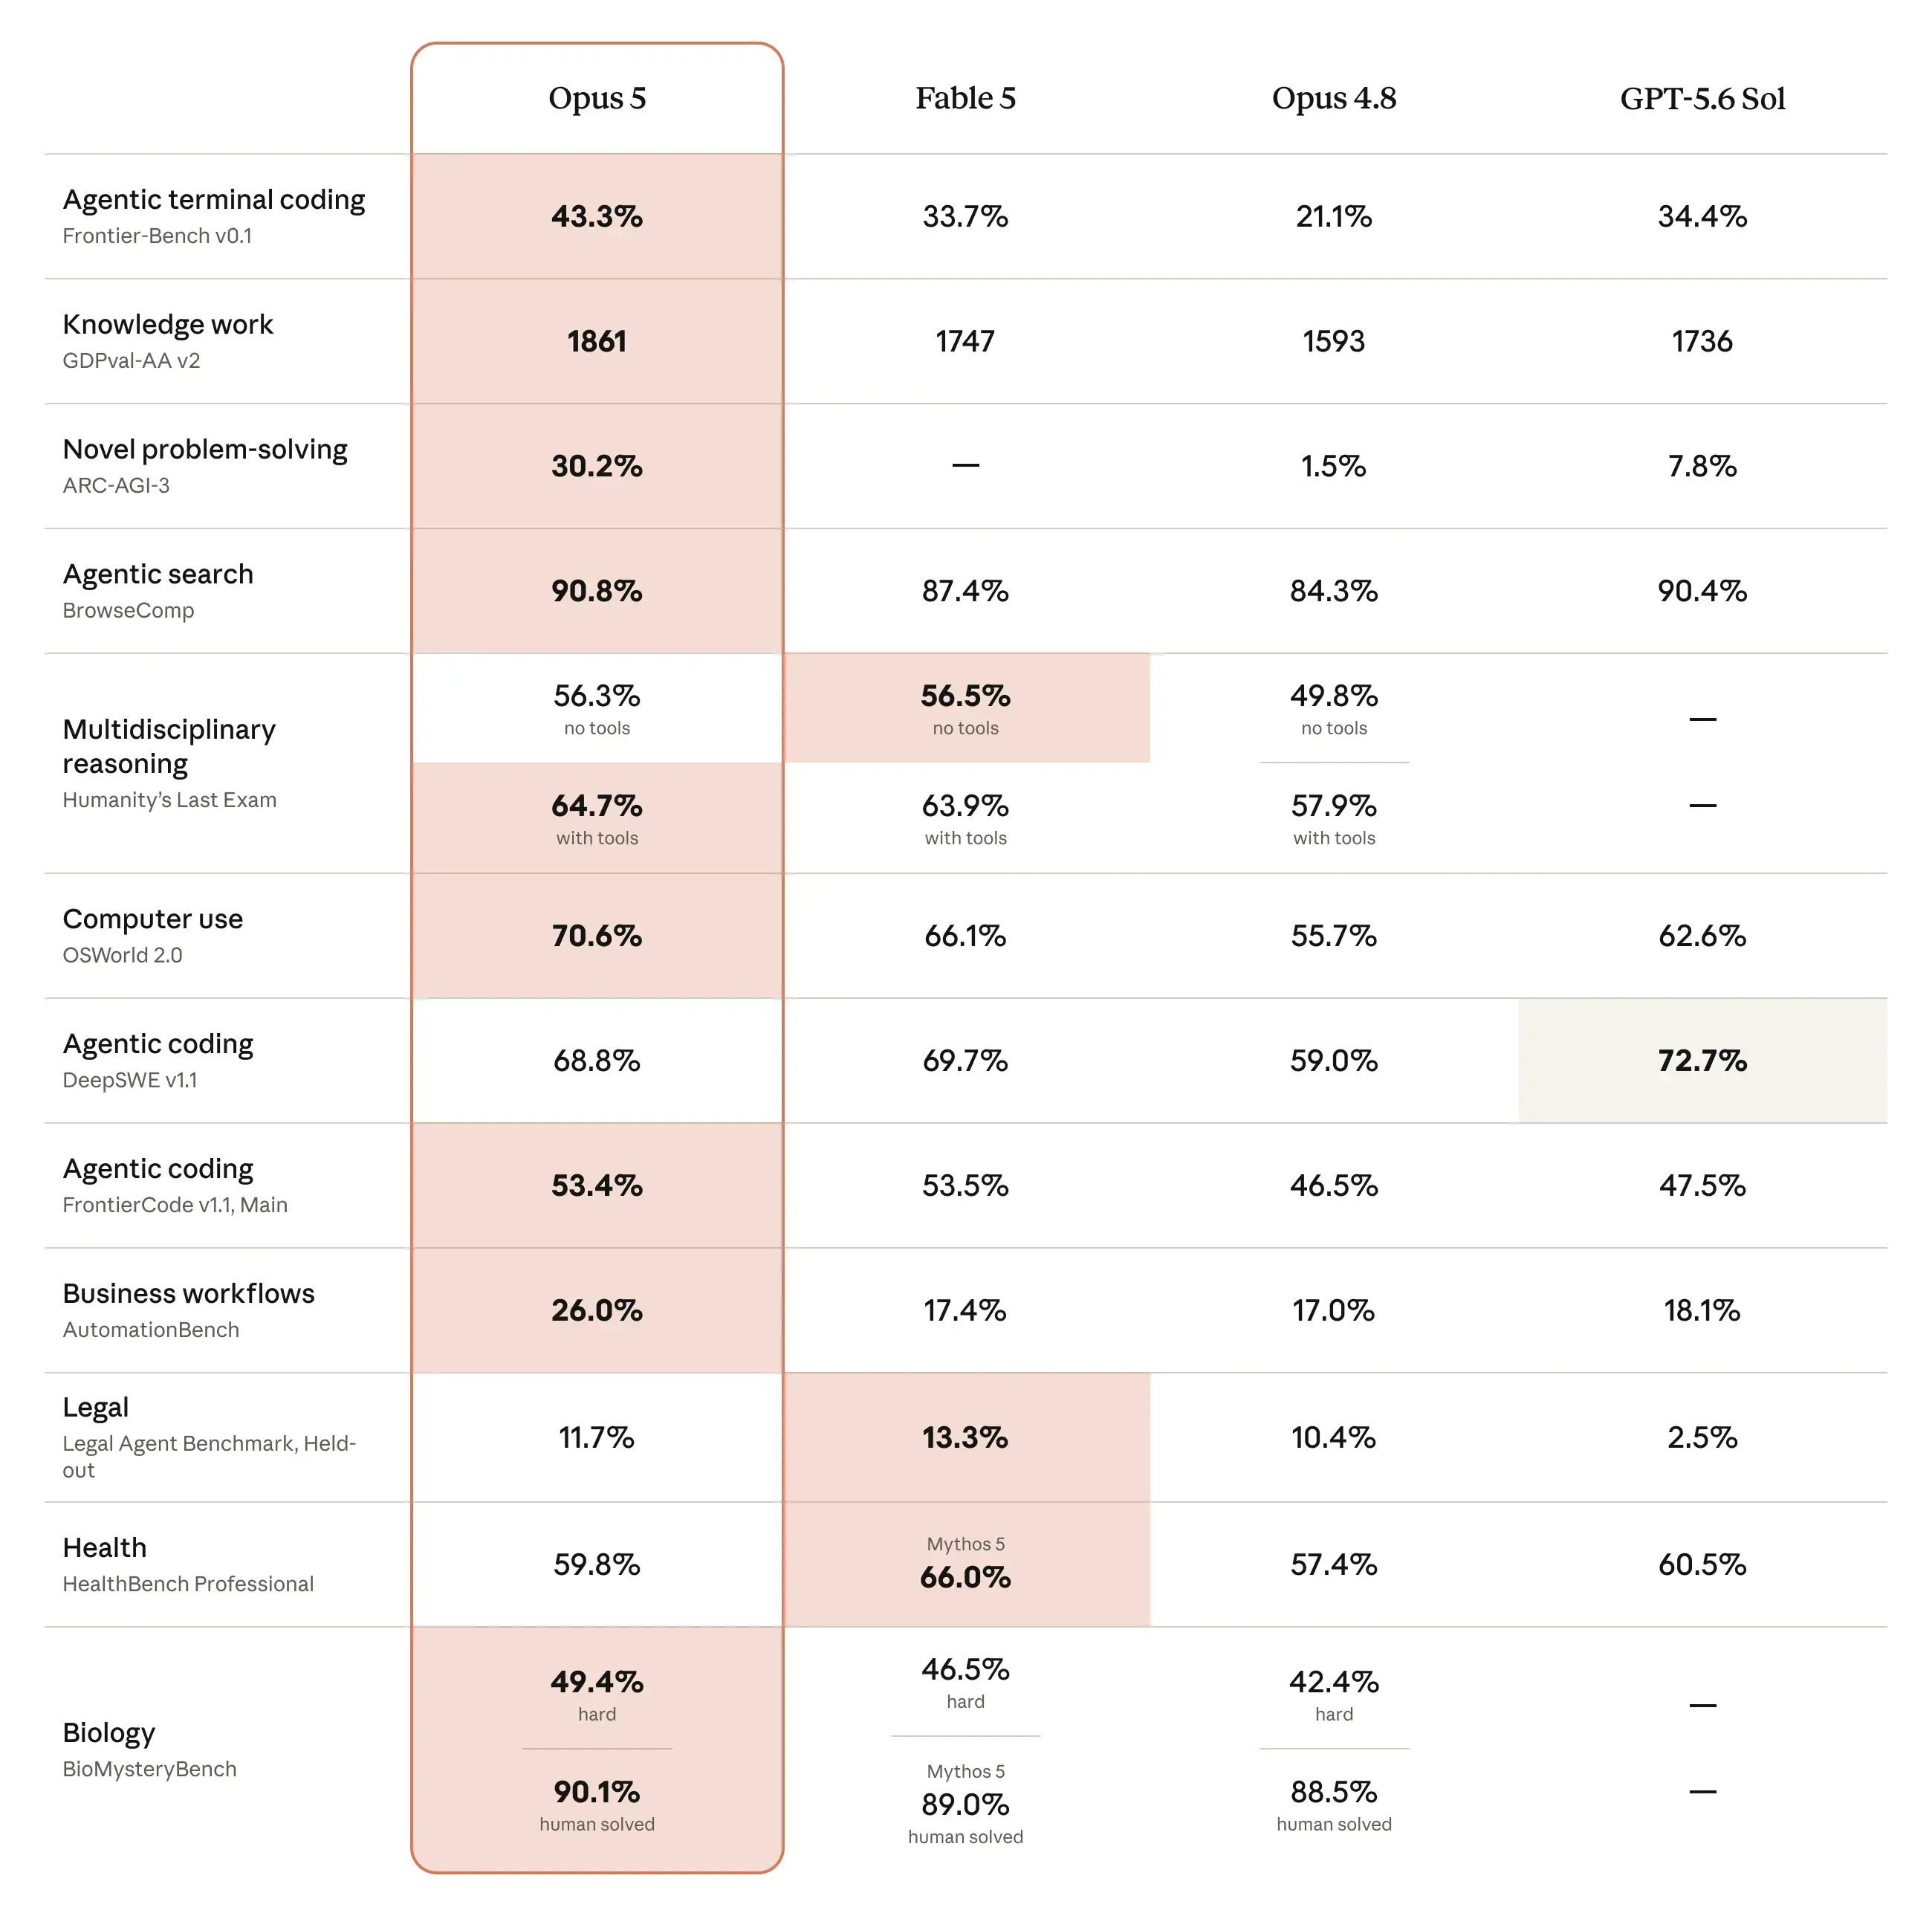
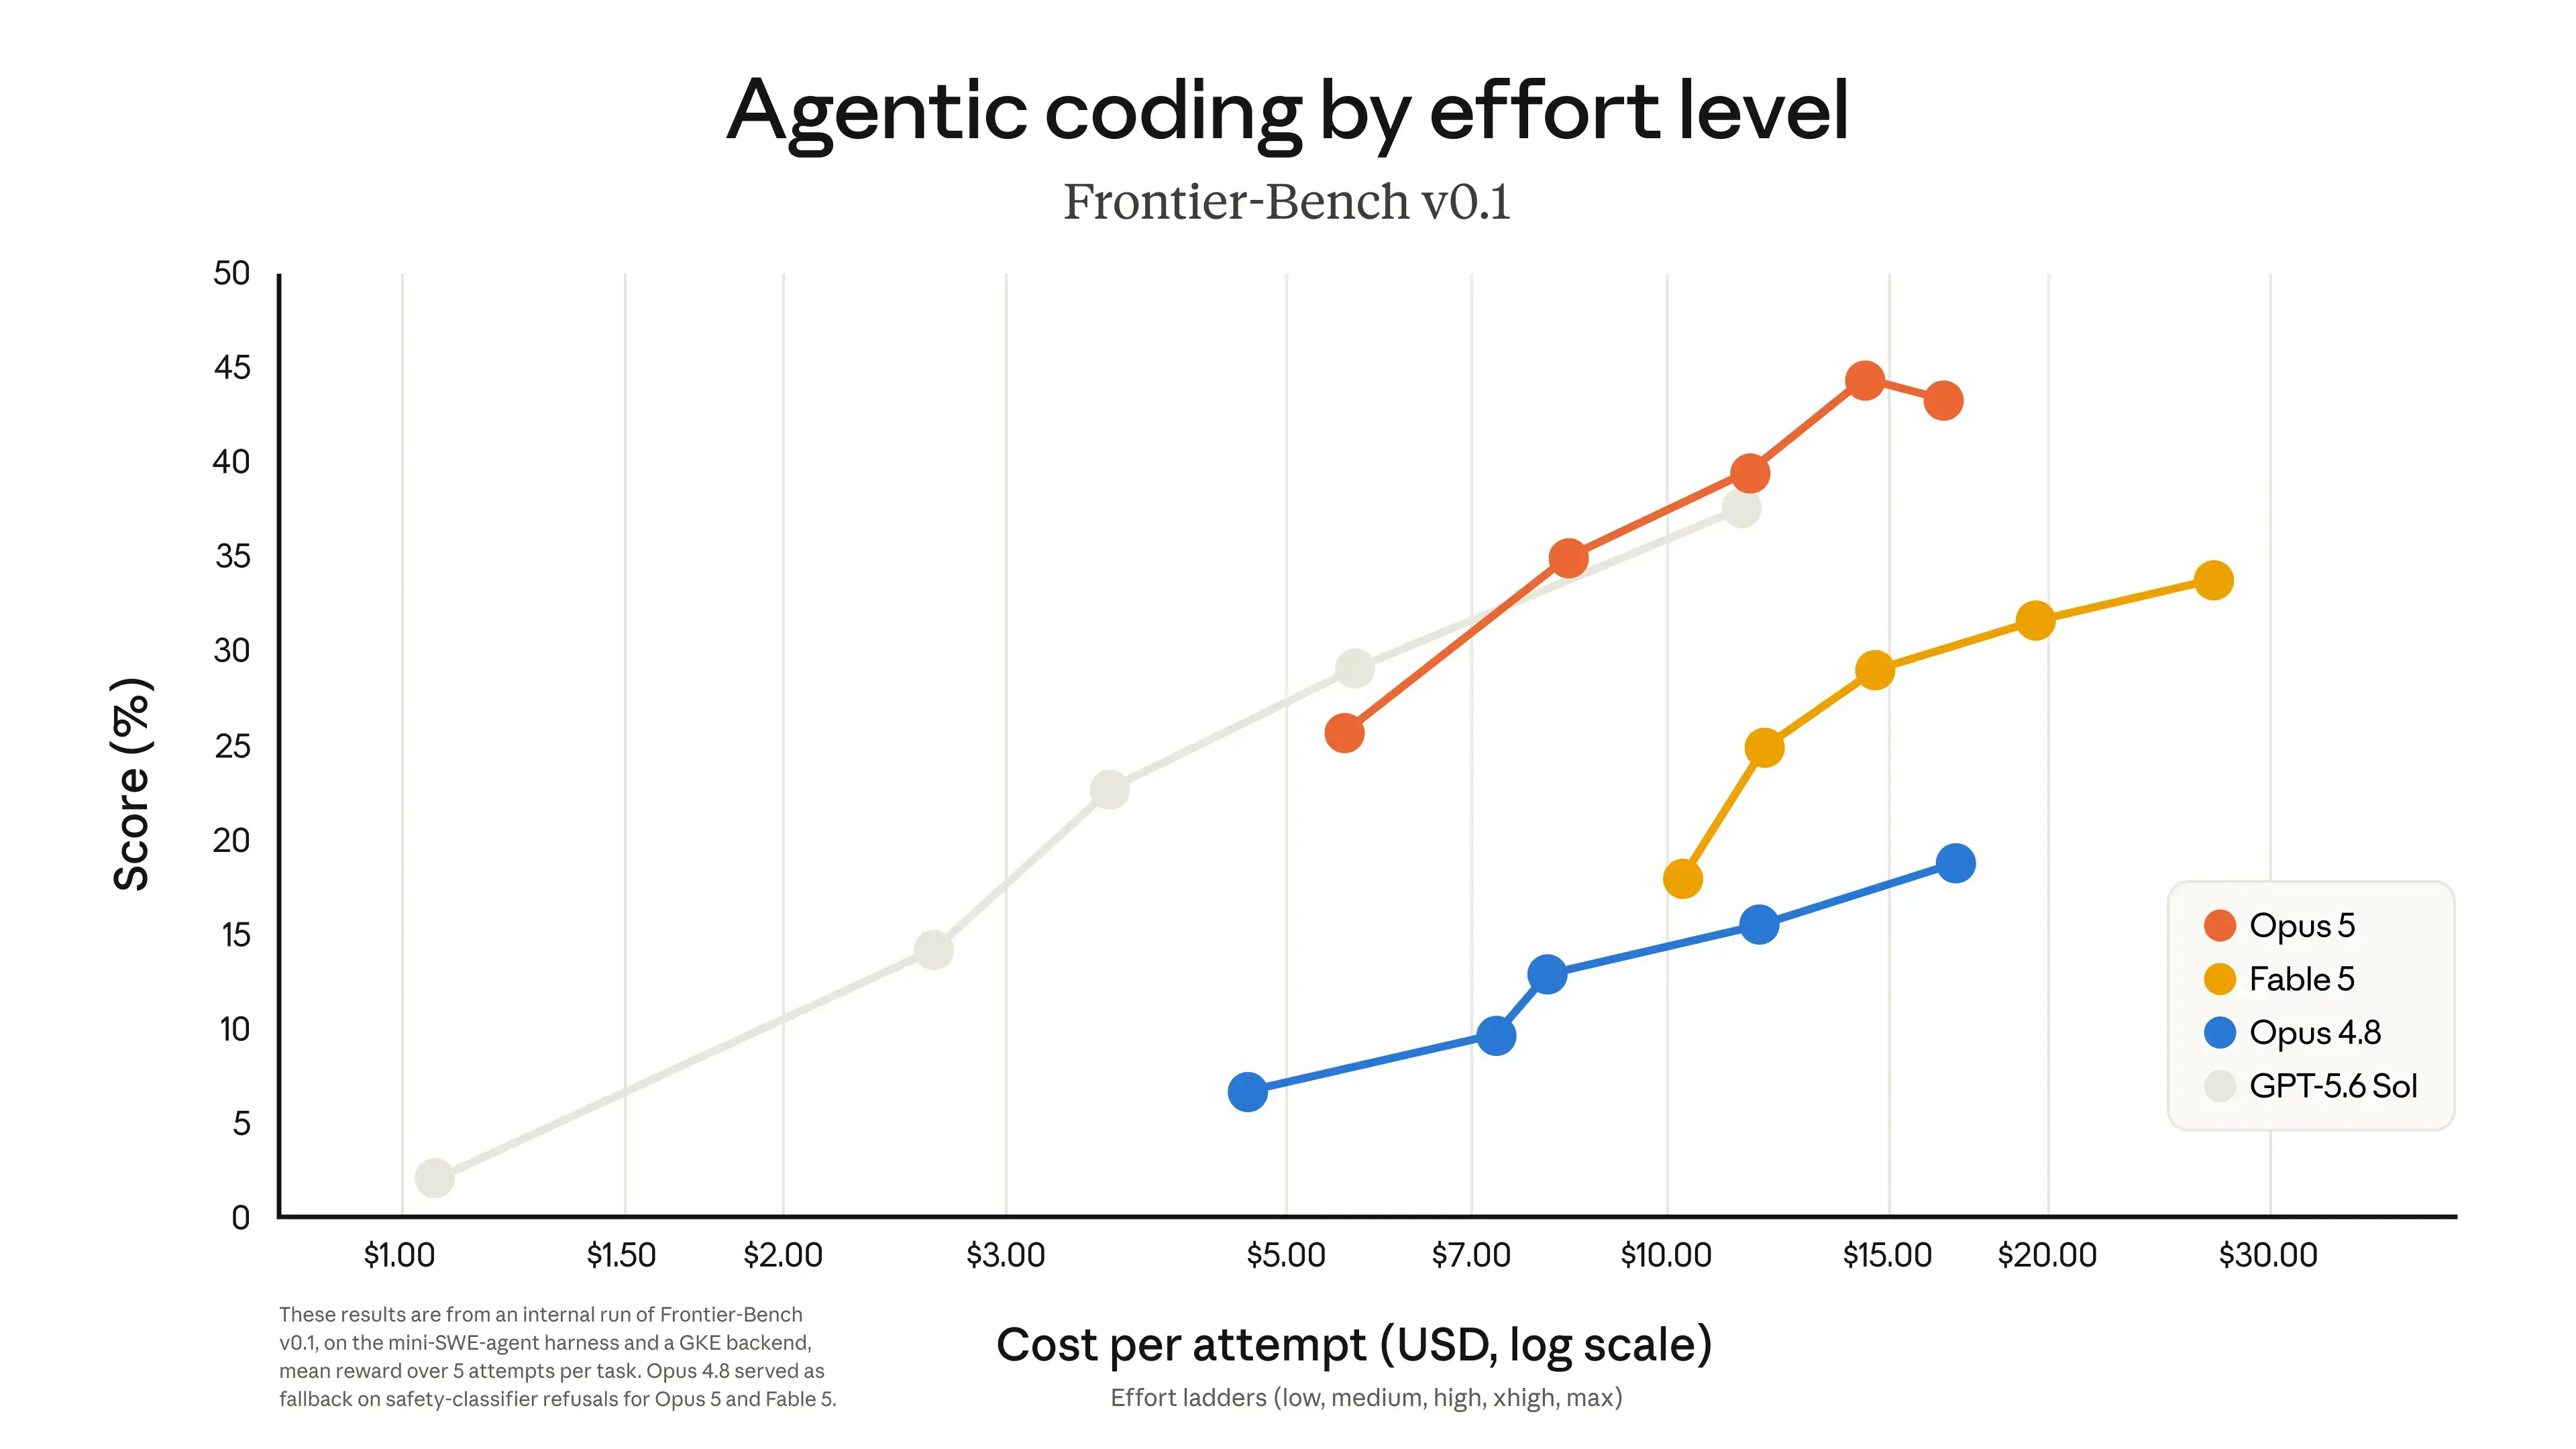
Claude Opus 5 在 Frontier-Bench 和 GDPval-AA 等评测中达到了当前最高水平 (SOTA)。在软件工程任务中,该模型在 Frontier-Bench v0.1 上的表现超过了所有对比模型,且在任务成本更低的情况下,性能达到 Opus 4.8 的 2 倍以上。
针对不同任务的细分表现如下:
- 在 CursorBench 3.2 的最高努力 (max effort) 设置下,其得分与 Fable 5 的峰值分数差距在 0.5% 以内,但单次任务成本仅为后者的一半。
- 在解决新颖问题的 ARC-AGI 3 测试中,Opus 5 的得分是目前次优模型的 3 倍。
- 在衡量端到端业务任务完成度的 Zapier AutomationBench 中,相同成本下的通过率约为次优模型的 1.5 倍。
- 在计算机使用 benchmark OSWorld 2.0 中,Opus 5 在任何给定成本下的表现均优于其他模型,且仅用约 1/3 的成本便超越了 Fable 5 的最佳结果。
强化科研能力与视觉输出
对于科学研究,Claude Opus 5 在生命科学的所有评测项中均优于 Opus 4.8,尤其在有机化学与生物信息学领域提升显著。在从光谱数据推断分子结构的内部 benchmark 中,其得分比 Opus 4.8 高出 10.2 个百分点;在预测蛋白质序列变异对功能影响的任务中,得分高出 7.7 个百分点。
此外,该模型显著增强了视觉输出能力,能够精准地将空气在空气动力学物体表面的流动过程可视化。
展现更强的自主代理(Agency)特质
Opus 5 在验证工作结果并自主迭代直至成功方面表现出极强的鲁棒性。据官方分享,在一次 Frontier-Bench 任务中,模型在无法直接查看零件图纸的情况下,自主编写了一套计算机视觉 pipeline 来从原始像素中提取几何信息,并成功重建了 3D FreeCAD 模型,而对比模型在 5 次尝试后均告失败。
其他实际应用案例包括:独立发现并修复了一个开源包管理器中被社区补丁遗漏的边缘 case 漏洞;以及在单一会话中为交易公司构建市场数据馈送,并自主开发 test harness 来验证解析代码的正确性。
对齐安全性与防御边界
在自动化行为审计中,Claude Opus 5 是 Anthropic 迄今为止最符合对齐要求的模型,其综合失配行为得分仅为 2.3,低于 Opus 4.8、Sonnet 5 及 Fable 5。该模型在遵循 Claude 宪法 (Constitution) 方面表现更佳,且产生欺骗性行为的概率最低。
在风险能力方面,Opus 5 在生物研究与进攻性网络安全领域仍落后于 Mythos 5。在 OSS-Fuzz 评测中,尽管 Opus 5 在识别软件漏洞方面的成功率与 Mythos 5 相当,但在开发漏洞利用 (exploit) 阶段的得分远低于后者。
定价、接入方式与 Beta 更新
Claude Opus 5 目前已在所有平台上线,定价与 Opus 4.8 保持一致,为输入 5 美元/百万 token,输出 25 美元/百万 token。开发者可通过 API 调用 claude-opus-5 接入。此外,模型提供 Fast 模式,运行速度约为默认速度的 2.5 倍,价格为基础价格的 2 倍。
随之发布的 Beta 更新包括:支持在对话过程中更改工具集而无需使 prompt cache 失效,以及 API 端的自动回退 (automatic fallbacks) 机制,当 Opus 5 或 Fable 5 的请求被安全分类器拦截时,可自动路由至次优可用模型。
Claude Opus 5 通过在成本不变的情况下大幅提升推理能力与自主性,进一步降低了在复杂软件工程与科学研究场景中的部署门槛。
评论 0