Anthropic 宣布自 6 月 15 日起调整 Claude 订阅套餐计费策略,将程序化调用与交互使用分离。符合条件的 Pro 至 Enterprise 等级用户将获赠专属的 Claude Agent SDK 月度额度,常规交互调用仍占用原有订阅限额。该策略标志着 Claude 订阅生态在自动化工作流领域的商业化探索进入新阶段。
Anthropic 宣布 Claude Code 周使用限额临时提升 50%,该调整即时生效并持续至 7 月 13 日。据官方公布,Pro、Max、Team 及按席位计费的企业用户均已自动获得该额度扩展,无需手动操作。
Anthropic 官方称,围绕 Claude 宪法编写的高质量文档与描写对齐 AI 的虚构故事,可将 Claude 代理失准降低到原来的三分之一以下。这些干预与评测场景无关,但效果在 reinforcement learning 后仍保留,并可与常规 harmlessness training 叠加。
据 God of Prompt 在 X 平台发帖称,Opus 4.7 提示词需要从 Claude Opus 4.6 的写法中迁移。帖文称,Claude Opus 4.7 在 SWE-bench 上达到 87.6%,高于 Opus 4.6 的 80.8%,但旧提示词可能因模型更严格执行字面指令而变窄、变短,甚至输出不完整。
据 Financial Times 报道,Anthropic 融资估值可能在新一轮交易中接近 1 万亿美元。知情人士称,这家 Claude 背后的 AI 公司正权衡今夏筹集数百亿美元,用于扩大计算能力。交易尚未敲定,Anthropic 与多家投资机构也未公开确认最终条款。
据 Epoch AI 估算,OpenAI 和 Anthropic 的人均营收已高于多家大型上市科技公司。Anthropic 的年化人均营收约为 900 万美元,OpenAI 约为 550 万美元;若两家公司上市,其人均营收或将超过 Forbes Global 2000 中所有公开交易的科技公司。这个指标不等同于利润率,但能反映 AI 实验室用较少员工撬动订阅、API 与企业收入的能力。
xAI 与 Anthropic 算力消化成为这轮算力竞争的新观察点。据原帖转述 The Information 报道,xAI 近期模型的 FLOPs 利用率约为 **11%**;Anthropic 则面临相反问题,Claude 需求增长快于可用容量,新增 SpaceX 算力容量被迅速转化为 Claude Code 与 Opus 的更高使用上限。
Anthropic 宣布将开源对齐评测工具 Petri 的开发移交给 AI 评估非营利机构 Meridian Labs,并同步更新到 Petri 3.0。Petri 3.0 对齐评测面向大语言模型的欺骗、阿谀和配合有害请求等风险行为,已被用于 Claude Sonnet 4.5 以来每个 Claude 模型的对齐评估。
Anthropic 正式发布 Claude Managed Agents 平台新功能。 本次 Claude Managed Agents 新功能覆盖梦境机制(Dreaming)自动提炼记忆、Outcomes 独立评分器引导自校正,以及多智能体并行编排。 Dreaming 功能目前处于研究预览阶段,其余功能已开放公共测试版。
传统的 AI 编码工具往往需要手动配置 Node.js 环境、解决 npm 权限错误、维护 PATH 变量,整个流程对初学者并不友好。Claude Code 作为 Anthropic 推出的命令行 AI 编码助手,2025 年 10 月起官方将原生安装器(native installer)确立为推荐安装方式,零依赖、自动配置 PATH、后台自动更新,把 Claude Code 安装流程压缩到一行命令。
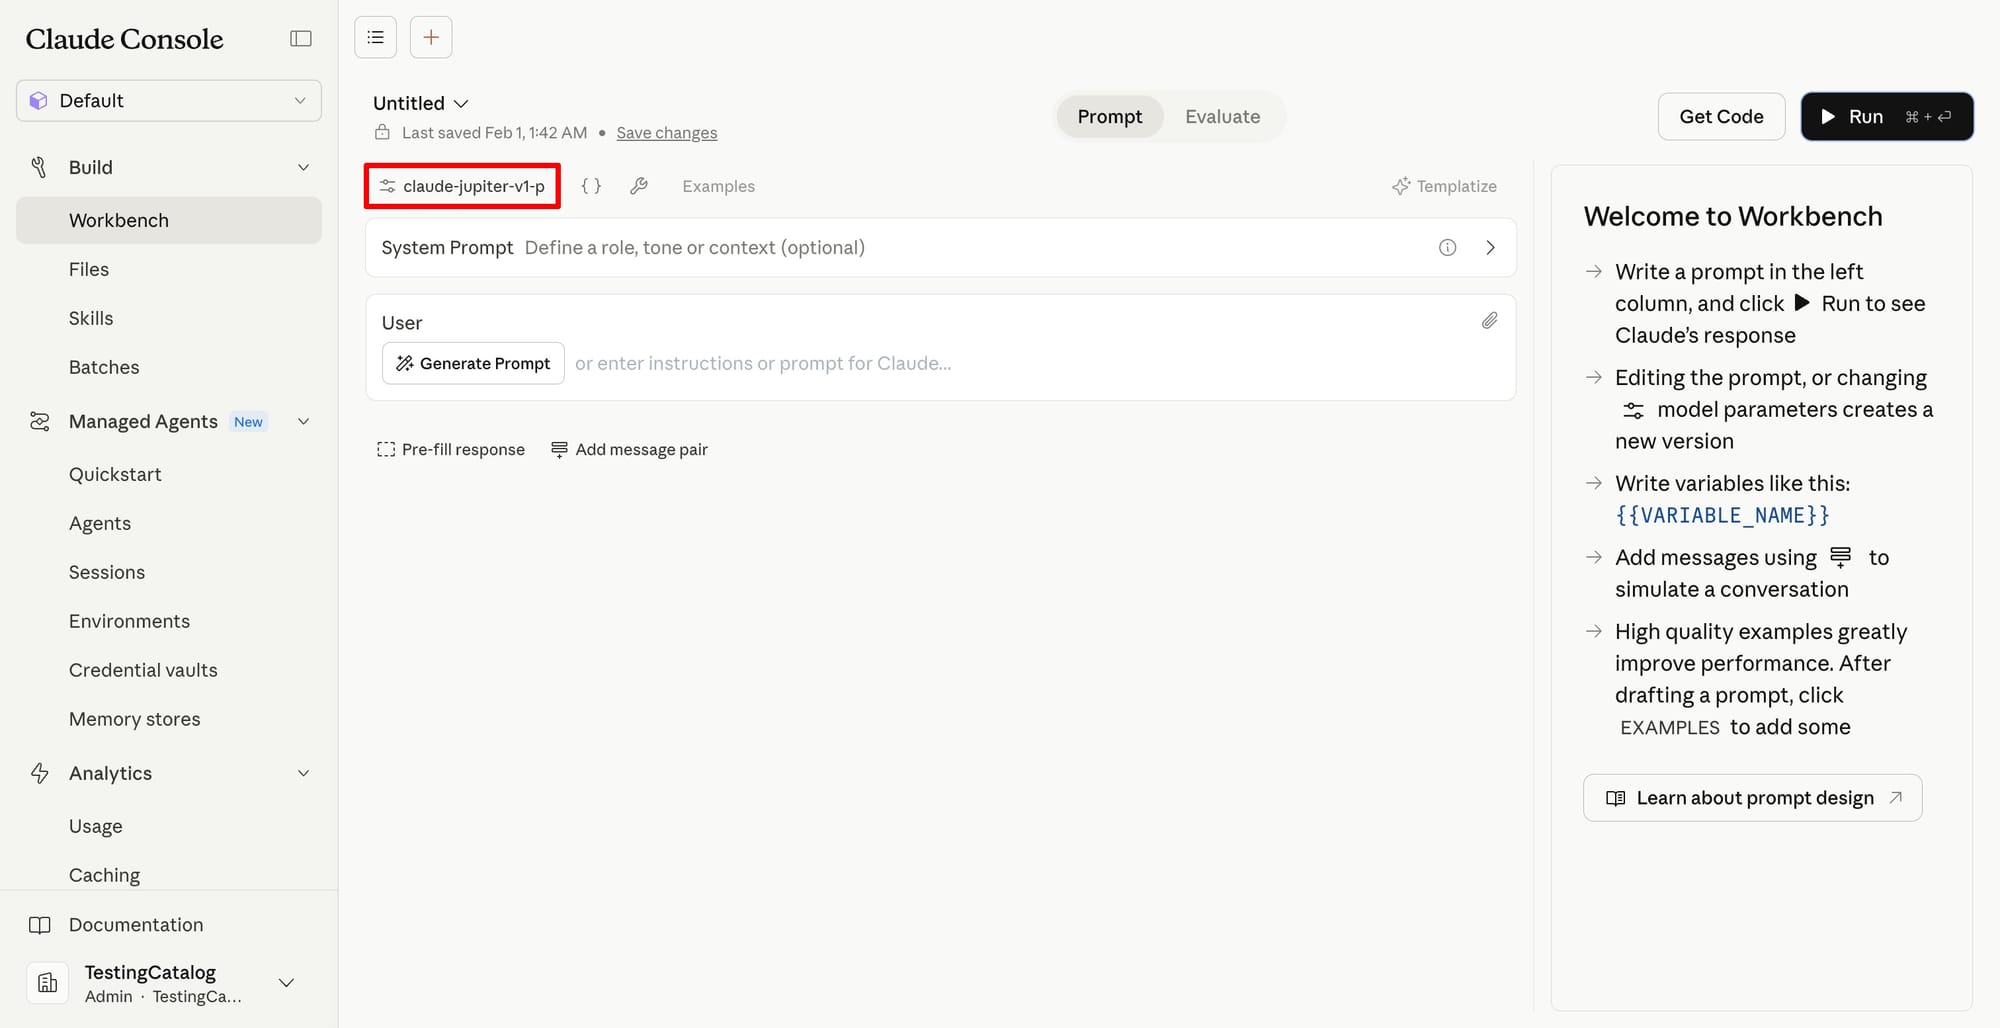
据 TestingCatalog 报道,Anthropic 已对内部代号 Claude Jupiter V1 的新构建启动红队测试。该代号疑似遵循 Anthropic 此前以行星名称作为预发布安全测试标签的惯例,时间点临近 2026 年 5 月 6 日的 Code with Claude 开发者大会。这一观察构成了 Claude Jupiter V1 红队测试 曝光与 Code with Claude 大会的临近信号,但是否对应实际产品发布仍需以 Anthropic 官方公告为准。