
Cloudflare 测试 Anthropic Mythos Preview 红队测试: 漏洞链式利用
据 Cloudflare 官方博客披露, 该公司近期在 Project Glasswing 内部项目中对 Anthropic Mythos Preview 完成深度安全红队测试。该模型可将散落在积压任务中的低危漏洞自动链式转换为真实利用链, 并独立编写、编译和运行 PoC 实现闭环验证。本次 Mythos Preview 红队测试不仅验证了模型在攻击面测绘中的突破能力, 也为安全团队的架构演进提供了关键数据。

漏洞链式利用突破传统边界
本次测试的核心发现并非模型捕捉到了多少单一漏洞, 而是其能够利用数个低危缺陷构建完整的利用链路。传统安全扫描器通常仅能孤立上报问题, 而该模型在测试中展现出类似高级研究员的推理能力。它能将释放后使用等底层缺陷转化为任意读写原语, 劫持控制流, 并利用 ROP 链夺取系统控制权。
更关键的是模型的闭环执行能力。发现漏洞与证明其可被利用存在本质差异, 该模型能自主编写触发代码, 在沙箱环境中编译运行, 并根据执行结果调整假设。这种编写、编译、运行、失败重试的迭代循环, 彻底跨越了推测性缺陷与真实利用之间的鸿沟。在 50+ 个代码库的扫描中, 该能力使得原本隐没在积压清单中的边缘缺陷转化为高严重性漏洞。
模型自发拒绝与安全护栏的不一致性
在受控测试环境下, 该模型并未搭载面向公开版模型的安全增强层, 但其仍表现出一定的自发拒绝倾向。部分请求会被模型有机地推回, 即便任务本身属于合法的安全研究范畴。这种自发护栏与模型的安全能力同源, 却缺乏稳定性。
测试数据显示, 相同任务在措辞微调或环境变更时可能产生截然相反的响应。例如模型可能先拒绝针对某代码库的漏洞研究, 随后在同一环境变更下同意执行; 或是在确认多个内存越界缺陷后拒绝编写演示利用代码。语义等价但呈现时机不同的提示词会导致概率性波动。这反映出有机拒绝不足以构成完整的安全边界, 未来面向公众的同类模型必须叠加显式护栏机制。
降噪策略与自动化评测 Harness 设计
安全漏洞定级的核心难点在于过滤信号与噪声, 该模型在内存不安全语言 (如 C 与 C++) 中产生的误报率显著高于 Rust 等内存安全语言。模型倾向于返回附带模糊修饰的假说, 导致大量投机性发现挤占人工审查资源。
为应对噪声, 团队构建了多层自动化评测 Harness。实践提炼出四项核心原则:缩窄作用域可提升发现质量; 引入对抗性审查能有效过滤初筛噪声, 要求独立 agent 使用不同提示词进行反向验证; 拆分离线问题可优化推理链条, 将代码缺陷判定与外部可达性判定交由不同模型处理; 并行窄域任务优于单一全量 agent。
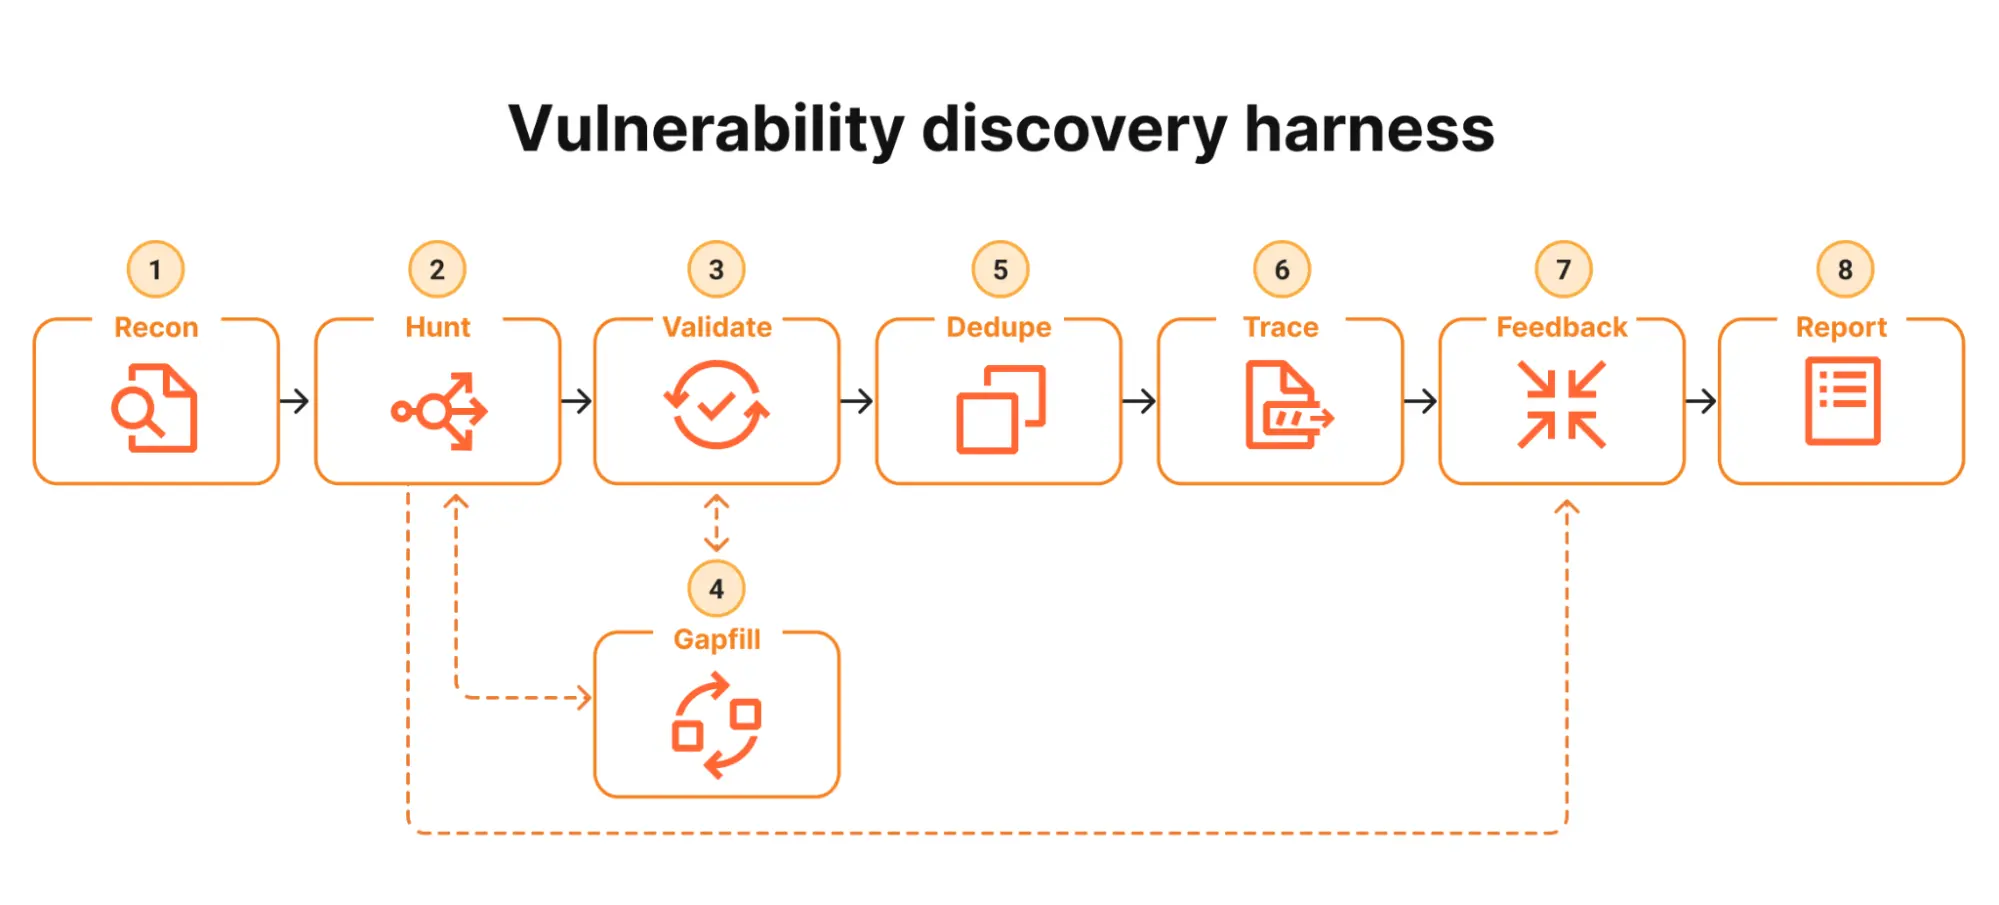
该 Harness 包含重建、狩猎、验证、差距补充、去重、追踪、反馈与报告八个阶段。重建阶段由 agent 自上而下梳理仓库并生成架构文档; 狩猎阶段约五十个并行 agent 针对不同攻击类展开探索; 验证阶段由独立 agent 尝试证伪初版结论; 追踪阶段通过跨仓库符号索引判定漏洞是否处于可达攻击面。 Harness 输出采用预定义 JSON Schema 生成结构化数据, 直接对接 ingest API 消除自由文本噪声。
安全响应 SLA 误区与架构防御演进
行业最直接的反馈往往聚焦于缩短周期, 部分团队正试图将 CVE 发布至代码上线的响应周期压缩至 两小时。据测试分析, 单纯追求修补速度在回归测试耗时不足的情况下极易引发次生故障, 甚至导致修补逻辑破坏了原有依赖关系。
防御重心需从速度转向架构韧性。核心思路是即便漏洞存在, 也需通过纵深防御提高利用门槛, 例如在应用前端部署攻击拦截层, 确保单点代码缺陷无法横向渗透至其他模块, 并实现修复补丁的全量同步下发。测试表明, 与修补速度相比, 控制漏洞暴露面的基础设施设计对降低实际威胁更具决定性。Cloudflare 表示其产品线将逐步落地上述架构原则, 为客户拦截跨应用层面的攻击路径。
考虑到基准数据与漏洞链评估均基于受控环境下的内部测试, 实际业务中的拦截效果与泛化能力仍需独立安全组织的长期验证。模型攻击面的演变正倒逼防御体系向自动化与架构韧性迁移, 后续演进值得持续观察。
评论 0