
谷歌发布 Gemma 4 12B 模型:采用无编码器架构支持笔记本本地运行
谷歌发布 Gemma 4 12B 模型, 采用无需编码器的统一架构, 旨在将多模态智能与 agent 能力直接带到个人笔记本电脑。据 Google 官方博文, 该模型在保持轻量化显存占用的同时, 推理能力接近 26B MoE 模型, 并首次为中型模型引入原生音频输入。

Gemma 4 12B 的统一架构设计
Gemma 4 12B 最大的技术突破在于采用了无编码器 (encoder-free) 的统一架构。传统多模态模型通常依赖独立的编码器将图像和音频转换为向量, 再传递给语言模型, 这会增加延迟并占用更多内存。
在该架构中, 视觉和音频输入直接流入 LLM 主干网络。具体实现方案如下:
- 视觉处理:用一个由单矩阵乘法、位置嵌入和归一化组成的轻量级嵌入模块取代了视觉编码器, 由 LLM 主干直接处理视觉信息。
- 音频处理:完全移除了音频编码器, 将原始音频信号直接投影到与文本 token 相同的维度空间。
硬件适配与性能表现
该模型定位为填补端侧 E4B 与高级 26B MoE 模型之间的空白, 在性能与资源消耗之间取得了平衡。其核心特性包括:
- 本地运行:仅需 16 GB VRAM 或统一内存即可在消费级笔记本上本地运行。
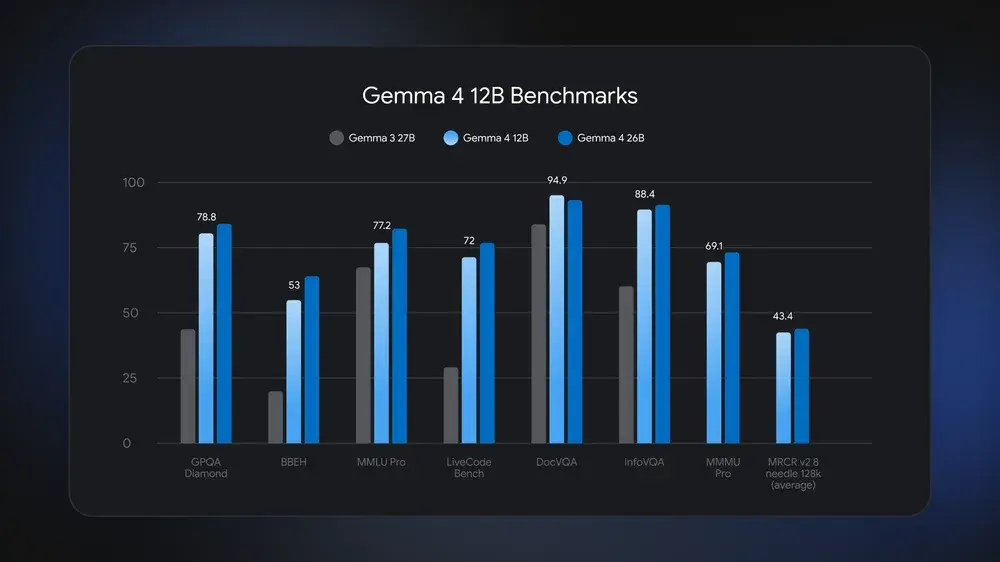
- 推理能力:在标准 benchmark 上表现接近 26B MoE 模型, 可支持复杂的多步推理与 agent 工作流。
- 降低延迟:配备了基于多 token 预测 (Multi-Token Prediction, MTP) 的草稿模型 (drafter), 显著提升推理速度。
开源生态与接入方式
谷歌将 Gemma 4 12B 以 Apache 2.0 许可证开放, 支持预训练和指令微调两种权重版本。开发者可以通过 Hugging Face 和 Kaggle 下载权重, 并使用以下工具链进行部署或优化:
- 推理框架:兼容 llama.cpp,MLX,SGLang,vLLM 以及 Hugging Face Transformers。
- 本地运行:支持 LM Studio,Ollama 以及 LiteRT-LM CLI。
- 高效微调:可通过 Unsloth 实现高效的 fine-tuning。
此外, 谷歌同步发布了官方 Skills Repository 技能库, 旨在通过提供专门设计的技能集, 降低开发者构建基于 Gemma 模型的智能体 (agent) 的门槛。
Gemma 4 12B 证明了在无需复杂编码器架构的情况下, 依然能实现高性能的多模态统一处理, 这为端侧 AI 应用在音频和视觉实时交互方面提供了更高效的工程路径。
评论 0