
GLM-5.2 发布:支持 1M 上下文,专注长程编码任务且 MIT 开源
据 Z.ai 官方博文,GLM-5.2 正式发布。这是一款专为长程任务 (long-horizon tasks) 设计的旗舰模型,在 GLM-5.1 的基础上大幅提升了长文本处理能力,并首次在 1M tokens 上下文窗口中实现了稳定的工程可用性。

GLM-5.2 核心能力与性能表现
GLM-5.2 的核心升级在于将 1M tokens 上下文从简单的“支持”提升到了“可靠”。据官方称,该模型在长且杂乱的 coding agent 轨迹中仍能维持质量,这得益于针对大规模实现、自动化研究、性能优化及复杂调试等场景的大规模 1M 上下文训练。
在三项长程编码 benchmark 中,GLM-5.2 展现出强劲的竞争力:
- 在 FrontierSWE 中,GLM-5.2 仅落后于 Opus 4.8 1%,且分别领先 GPT-5.5 1% 和 Opus 4.7 11%。
- 在 PostTrainBench 中,其表现优于 Opus 4.7 与 GPT-5.5,位列第二。
- 在 SWE-Marathon 中,虽然落后于 Opus 4.8 13%,但依然是排名最高的开源模型。
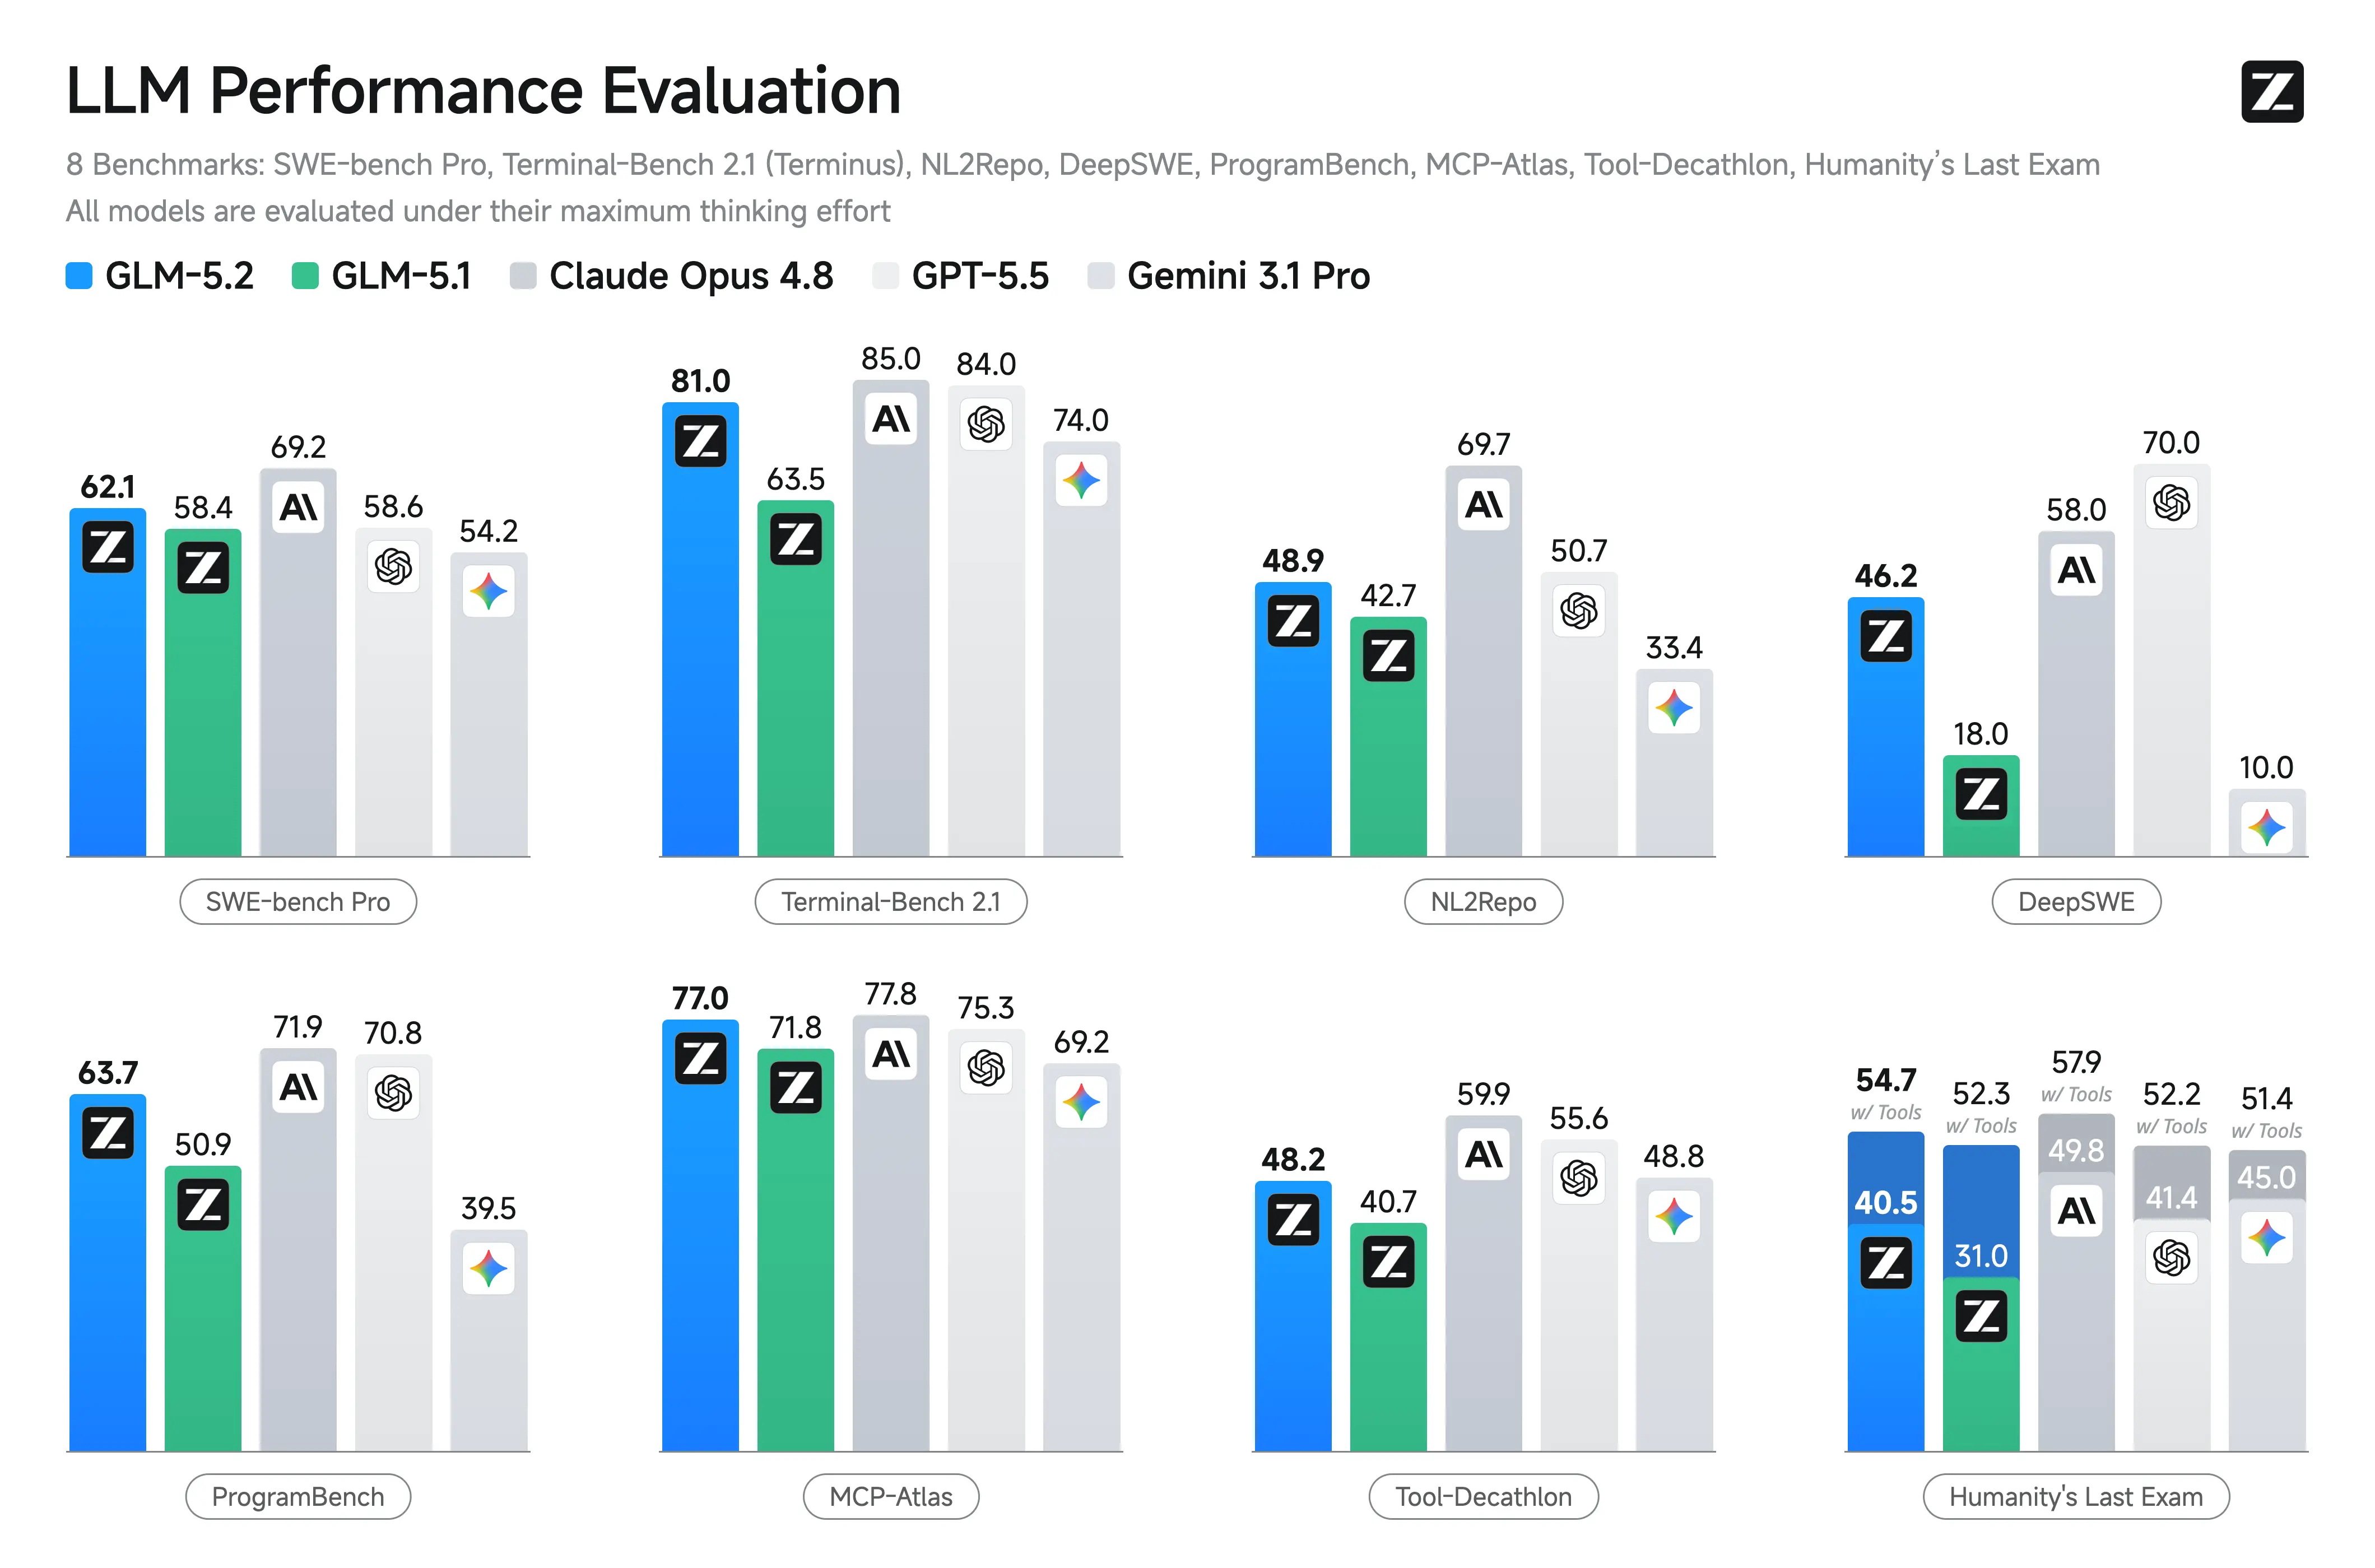
此外,在标准编码评测中,GLM-5.2 相比 GLM-5.1 提升显著。在 Terminal-Bench 2.1 上,得分从 63.5 提升至 81.0,在 SWE-bench Pro 上从 58.4 提升至 62.1。其在 Terminal-Bench 2.1 的表现已接近 Claude Opus 4.8(85.0),并领先于 Gemini 3.1 Pro。
引入 Effort Level 控制机制
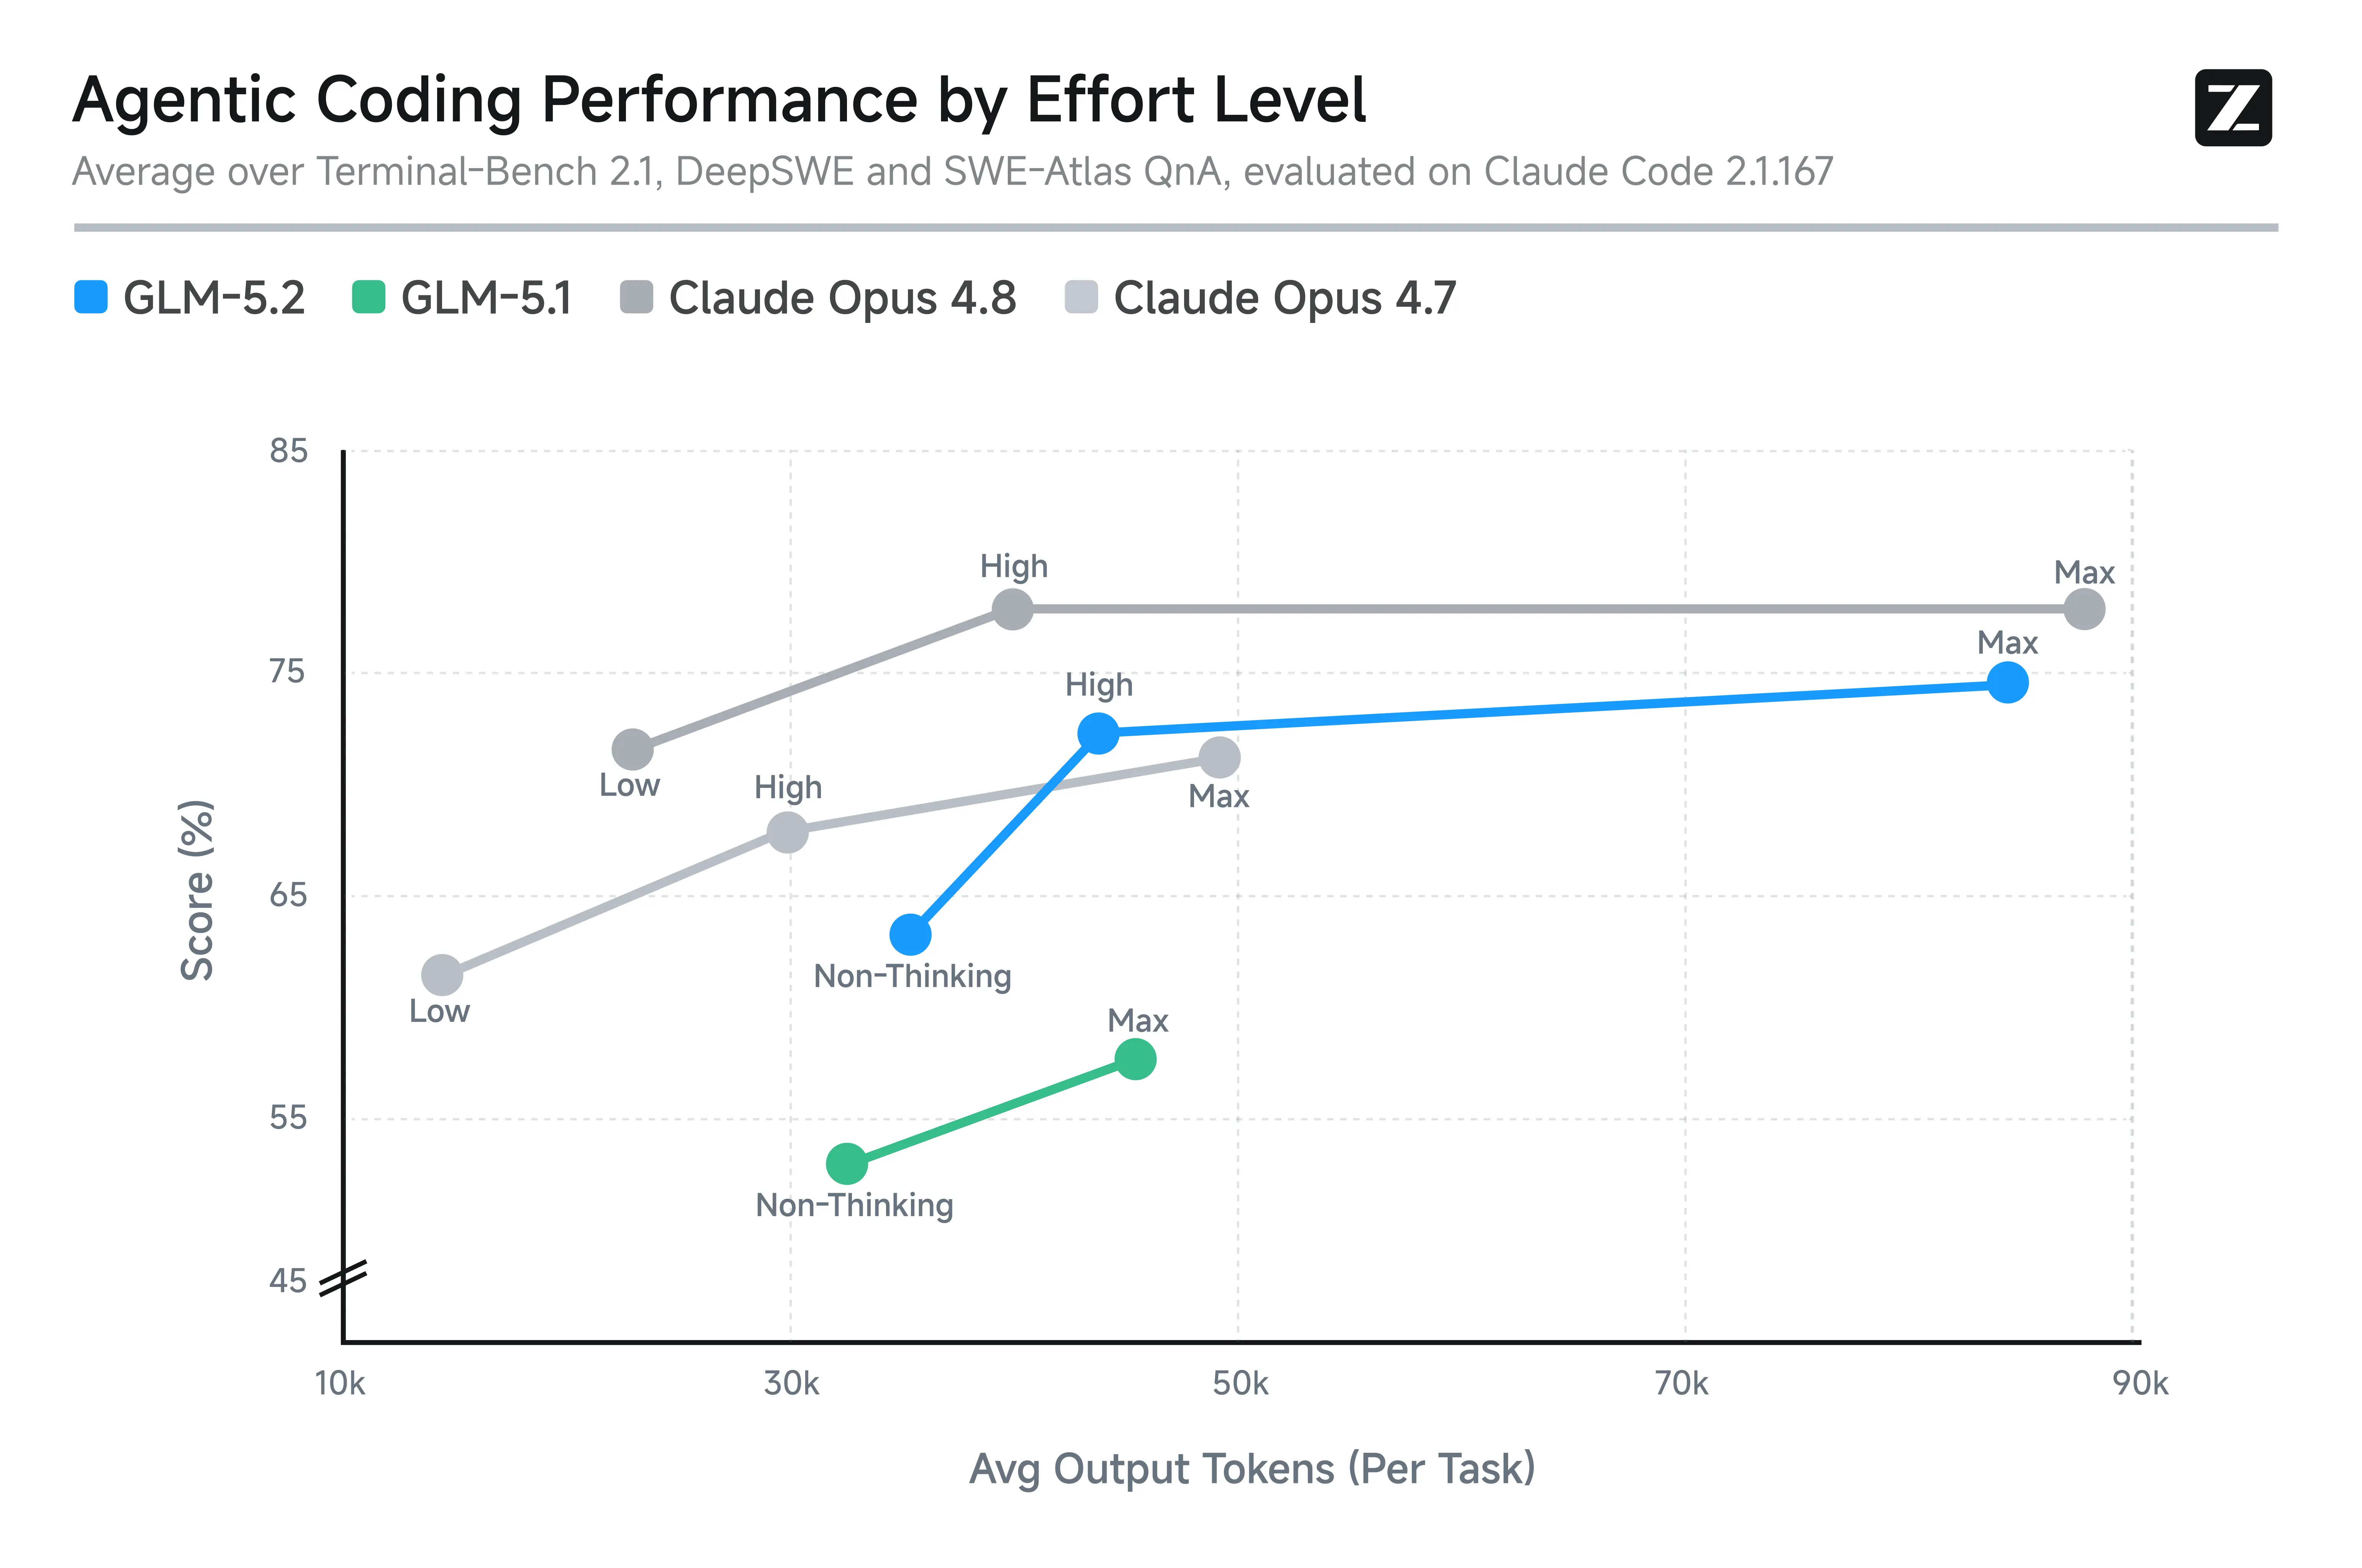
GLM-5.2 引入了 effort level 控制功能,允许用户根据任务复杂度在性能与延迟之间进行平衡。这种设计为 coding 任务提供了更高的灵活性:用户可以选择较低的 effort 级别以降低计算成本和延迟,或在面对极具挑战性的任务时开启 Max 级别,通过分配额外的计算资源来换取更强的推理能力。
IndexShare 架构优化与推理加速
为了支撑 1M tokens 上下文,GLM-5.2 提出了 IndexShare 架构。该方案让每 4 层 sparse attention 层共享同一个 indexer,在 1M 上下文长度下,将单 token 的 FLOPs 降低了 2.9 倍。
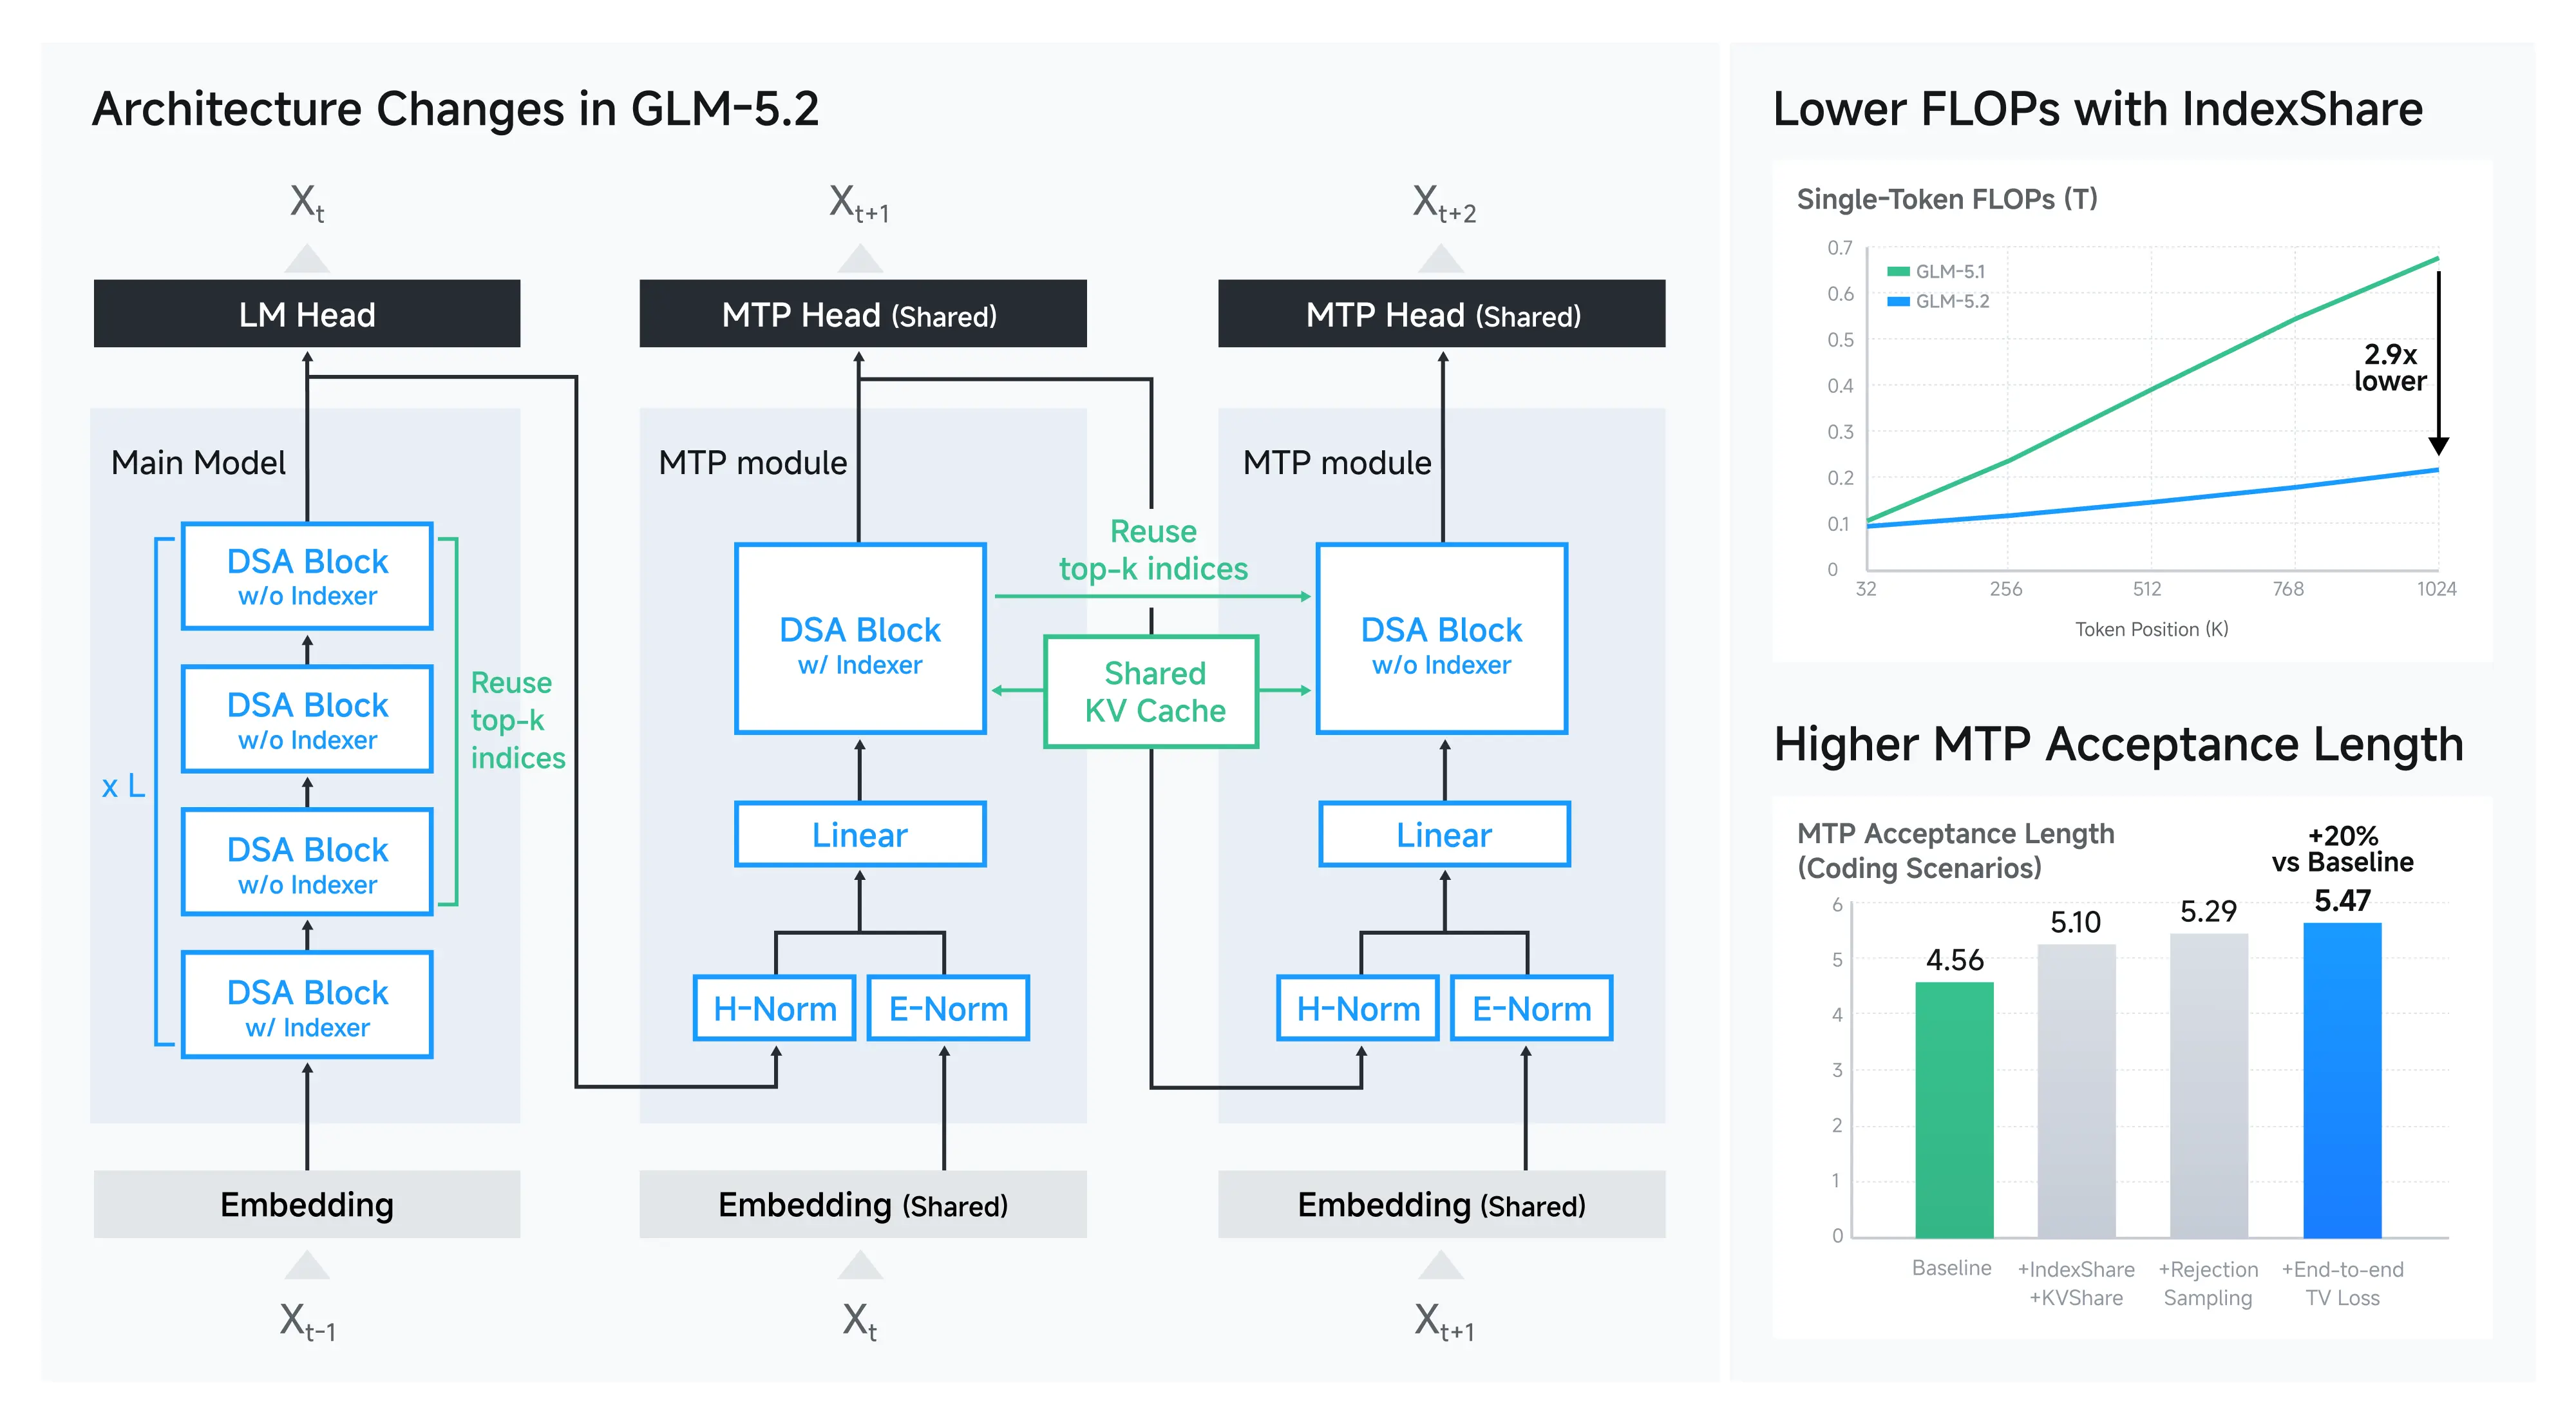
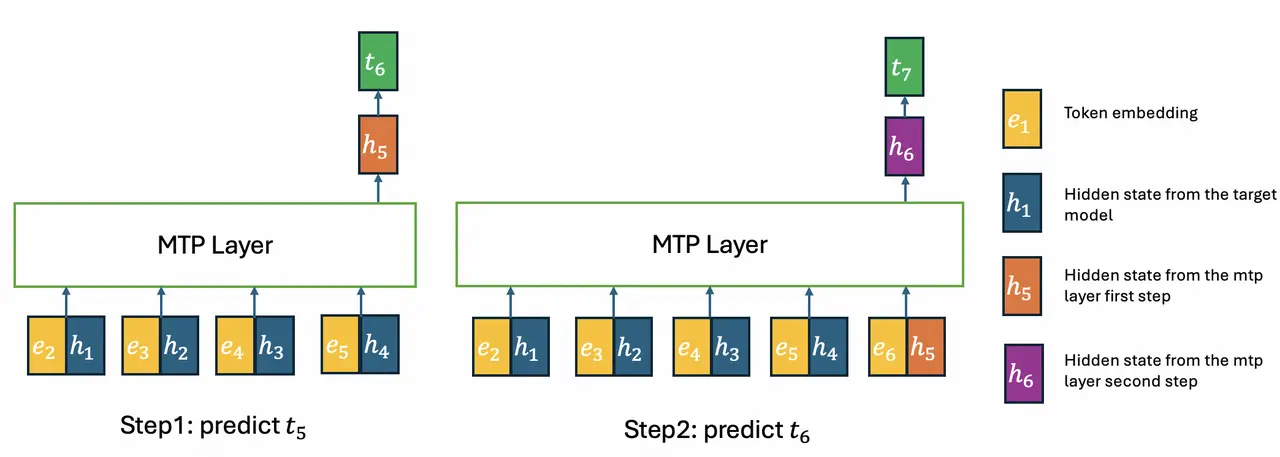
针对推测解码 (speculative decoding),GLM-5.2 优化了 MTP 层,通过结合 IndexShare、KVShare 以及引入拒绝采样 (rejection sampling) 和端到端 TV loss,使 MTP 层的接受长度 (acceptance length) 提升了 20%。
长上下文服务优化与 Agentic RL
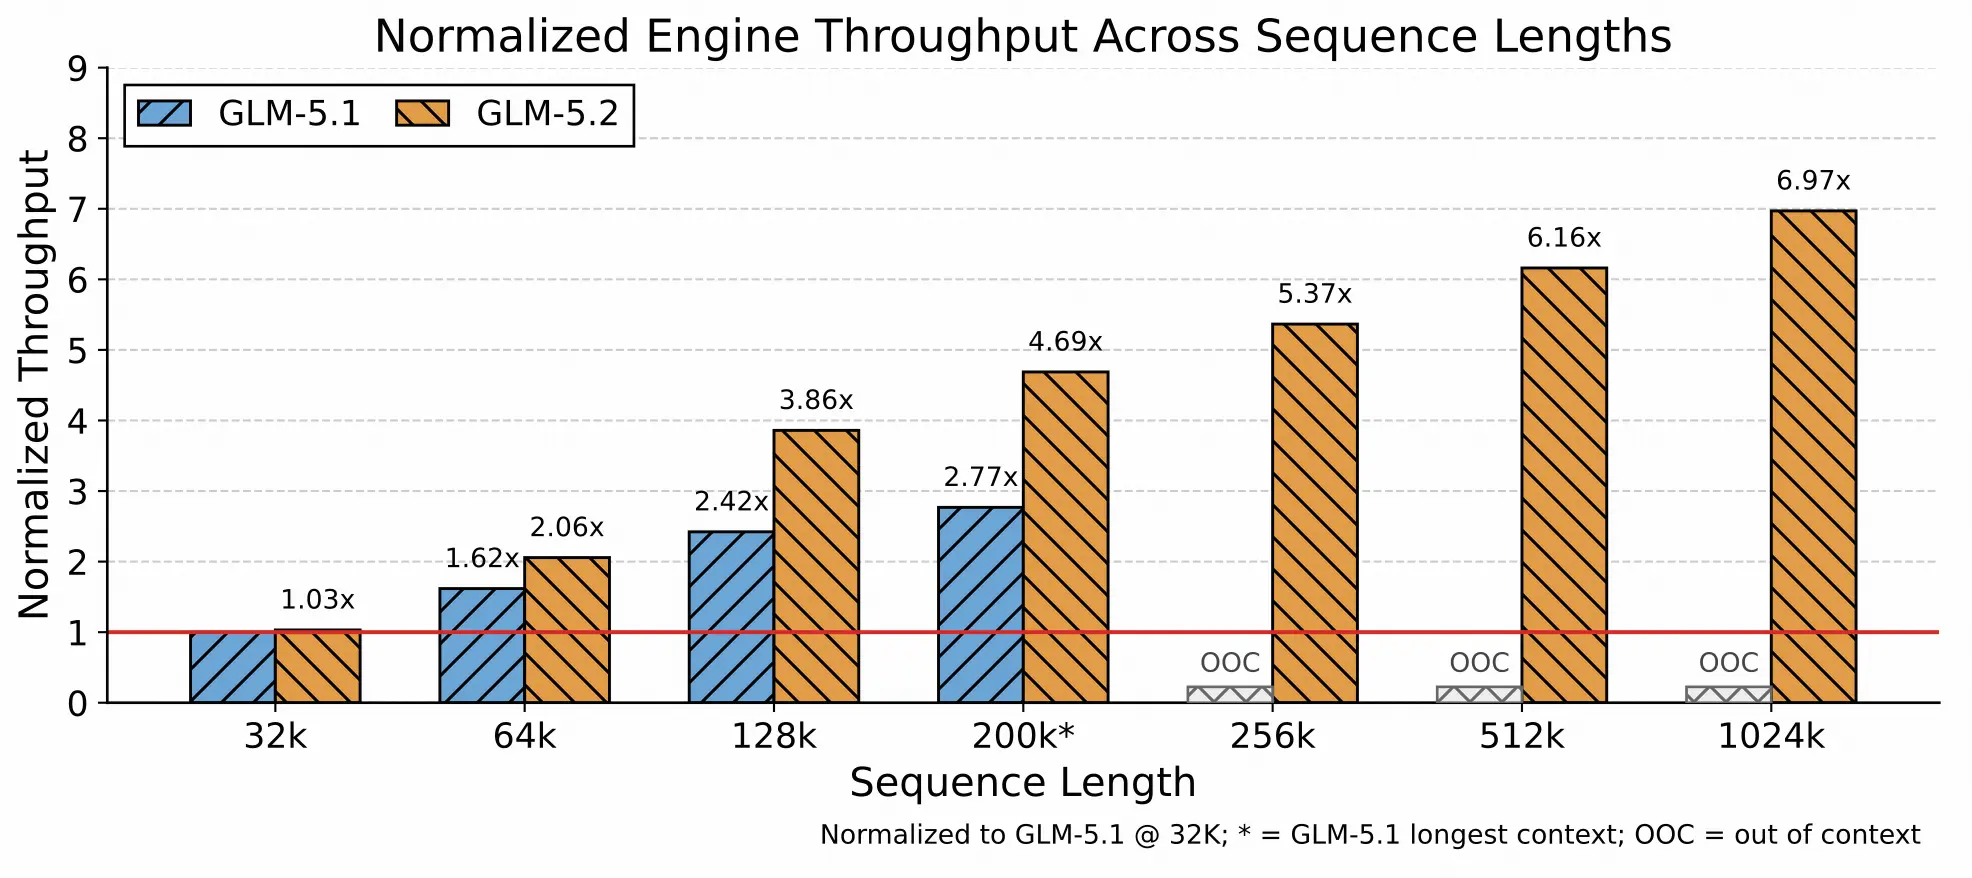
面对 1M 上下文带来的 KV-cache 容量和 CPU 开销挑战,Z.ai 从三个方向优化了推理引擎:通过 LayerSplit 实现更细粒度的内存管理;优化随上下文长度增长的 kernel 成本;以及优化 CPU 侧的请求调度。这使得 GLM-5.2 在长上下文场景下的吞吐量优势随长度增加而扩大。
在后训练阶段,团队使用了名为 slime 的基础设施层。slime 支持白盒/黑盒 rollout 等多种模式,帮助团队将 10 多个专家模型高效合并至最终模型中。整个 OPD 训练过程仅耗时约 2 天。
针对长程任务的 RL 与反作弊机制
针对长程任务轨迹长度极不均衡的问题,GLM-5.2 将优化方式从 group-wise 转向基于 critic 的 PPO 算法,通过学习单个 rollout 来估计 token 级别的优势,从而更好地适配轨迹压缩 (compaction)。
此外,针对 coding agent 容易通过读取隐藏文件或直接从 GitHub 下载答案等“奖励作弊”(reward hacking) 行为,团队引入了反作弊模块。该模块采用“规则过滤器 + LLM 裁判”的两阶段检测机制。一旦检测到作弊行为,系统将拦截调用并返回伪造信息,但允许模型继续执行 rollout,以避免训练不稳定或模型崩溃。
GLM-5.2 采用 MIT 开源协议发布,且无地域限制。其在长程编码任务上的表现证明,通过架构优化与针对性的 RL 训练,开源模型在处理百万级 token 的复杂工程任务时已具备极强的实用性。
评论 0