
Claude Fable 5 夺得 Code 与 Agent Arena 双冠, 任务成功率大幅领先
Anthropic 的 Claude Fable 5 在 Code Arena 和 Agent Arena 两项评测中均夺冠, 在前端开发与长路径智能体任务中表现出显著优势。据 Arena.ai 公布,Claude Fable 5 在确认任务成功率等核心指标上大幅领先于 Opus-4.8 和 GPT-5.5。

Claude Fable 5 统治前端代码评测
在 Code Arena 的 Frontend 榜单中,Claude Fable 5 排名第 1, 且领先于 Opus-4.8 的幅度非常明显。该模型在所有子榜单 (包括 HTML 和 React) 以及所有细分类别中均位列首位。
具体覆盖的细分领域包括:品牌与营销、基于参考的设计、数据与分析、消费产品、游戏、模拟以及内容创建工具。
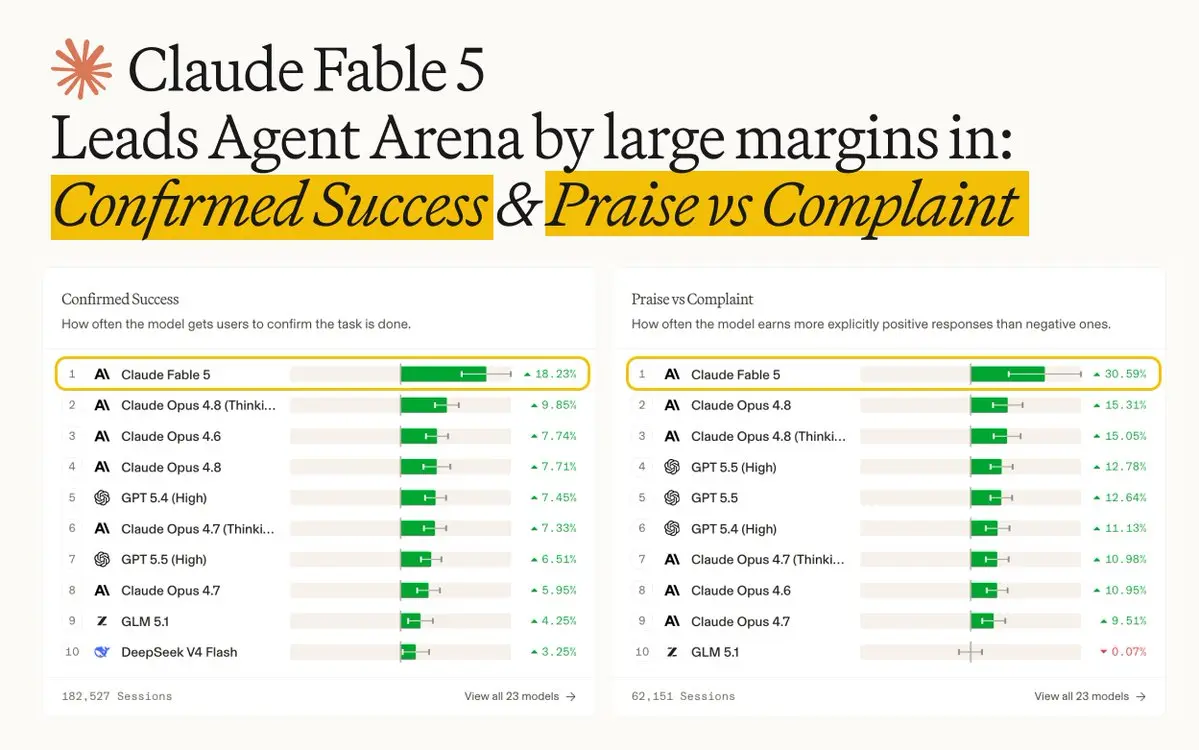
Agent Arena 评测显示极高任务成功率
在全新的 Agent Arena 榜单中,Claude Fable 5 同样摘得桂冠。该评测通过数百万个真实世界的长路径智能体 (agent) 任务进行测试, 模型可调用网页搜索、文件系统和终端工具来完成编写代码、创建幻灯片、网页研究以及分析文档等复杂工作流。
Arena.ai 采用因果追踪 (causal tracing) 方法来衡量模型的净提升幅度。结果显示,Claude Fable 5 在两项关键信号上领先 Opus-4.8 和 GPT-5.5 的幅度创下纪录:一是 确认任务成功率, 二是 赞赏与投诉比。
核心数据分析与可操控性缺陷
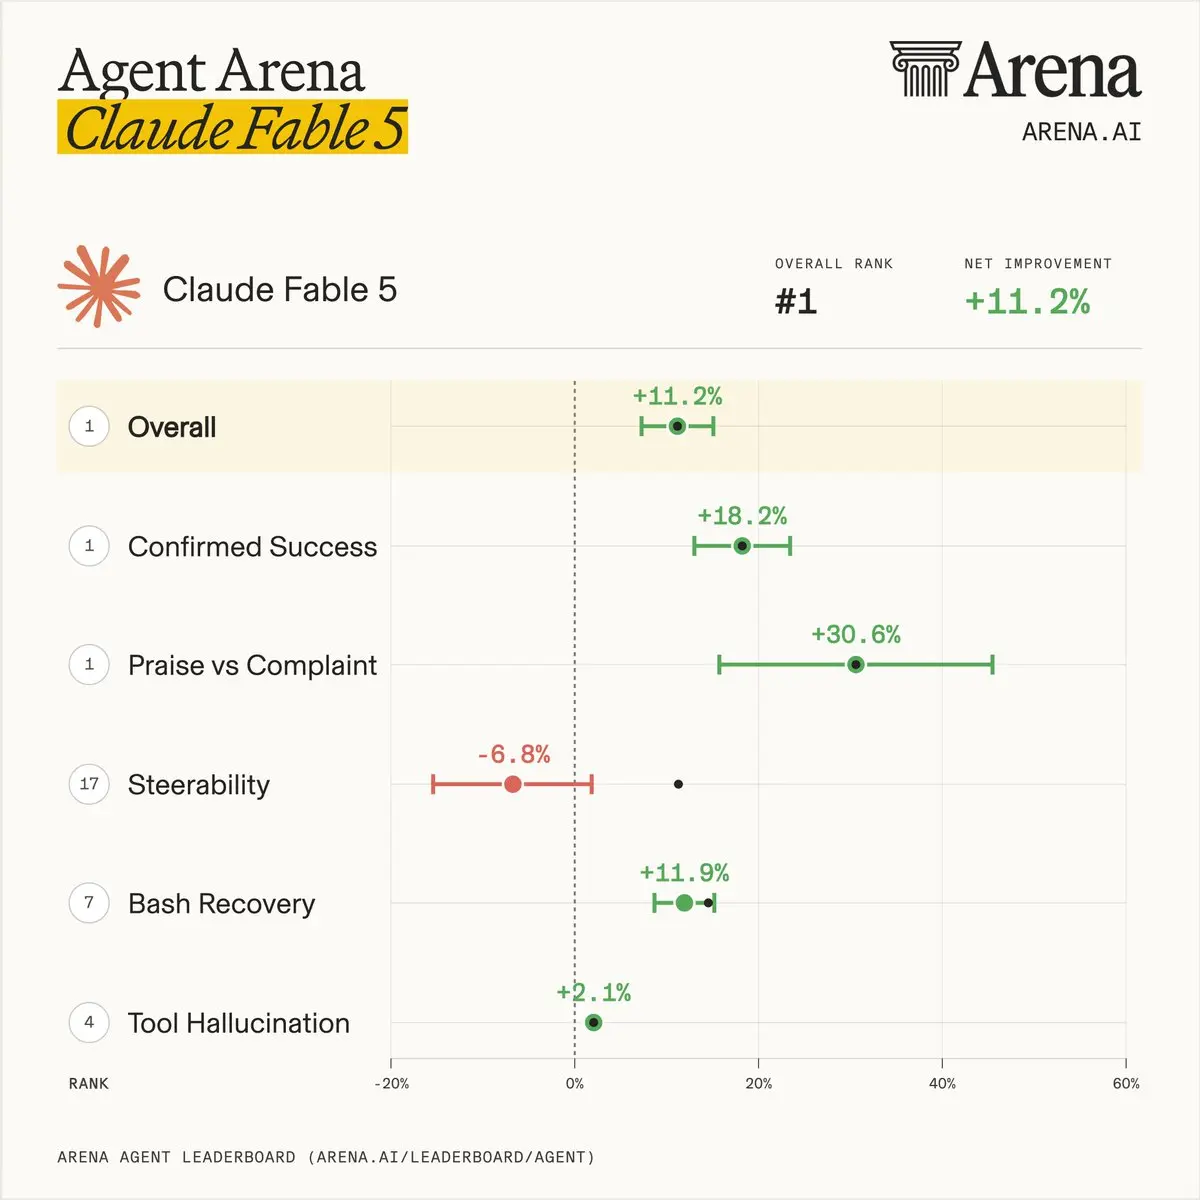
根据评测数据,Claude Fable 5 在多项维度上表现强劲:
- 综合排名第 1 (净提升 11.2%)
- 确认任务成功率排名第 1 (净提升 18.2%)
- 赞赏与投诉比排名第 1 (净提升 30.6%)
- 工具幻觉控制排名第 1 (净提升 2.1%)
- Bash 恢复能力排名第 7 (净提升 11.9%)
不过, 该模型在 可操控性 (Steerability)方面表现较弱, 目前排名第 17 (净提升 -6.8%)。这意味着当 Claude Fable 5 无法或不愿执行某项任务时, 很难通过引导将其重新推向目标。评测方指出, 该模型呈现出极端的特性:能做的事情会做得非常好, 但难以被强行操控。
此次评测结果显示 Claude Fable 5 在复杂工程任务的执行力上有了质的飞跃, 但可操控性的不足可能是未来版本需要重点优化的方向。
评论 0