
Moonshot 发布开源代码模型 Kimi-K2.7-Code, 推理 token 消耗降低 30%
Moonshot 发布开源代码模型 Kimi-K2.7-Code, 在多项编程与智能体评测中较前代 K2.6 有显著提升, 并降低了 30% 的推理 token 消耗。据 Hugging Face 页面披露, 该模型旨在增强复杂软件工程工作流中的端到端任务完成能力。

Kimi-K2.7-Code 核心架构与参数
Kimi-K2.7-Code 基于 Kimi K2.6 构建, 采用 Mixture-of-Experts(MoE) 架构。该模型总参数量为 1T, 每次推理激活参数为 32B, 包含 61 层结构, 其中仅包含 1 层 Dense 层。
在具体技术规格方面, 模型采用 MLA 注意力机制与 SwiGLU 激活函数, 上下文窗口长度为 256K, 词表大小为 160K。视觉编码器采用 MoonViT, 参数量为 400M。此外, 模型采用了与 Kimi-K2-Thinking 相同的原生 int4 量化方法。
编程与智能体能力评测
据官方公布,Kimi-K2.7-Code 在多项 benchmark 中表现出强劲的增长。在编程能力方面,Kimi Code Bench v2 提升 21.8%(达到 62.0),Program Bench 提升 11.0%(达到 53.6),MLS Bench Lite 提升 31.5%(达到 35.1)。
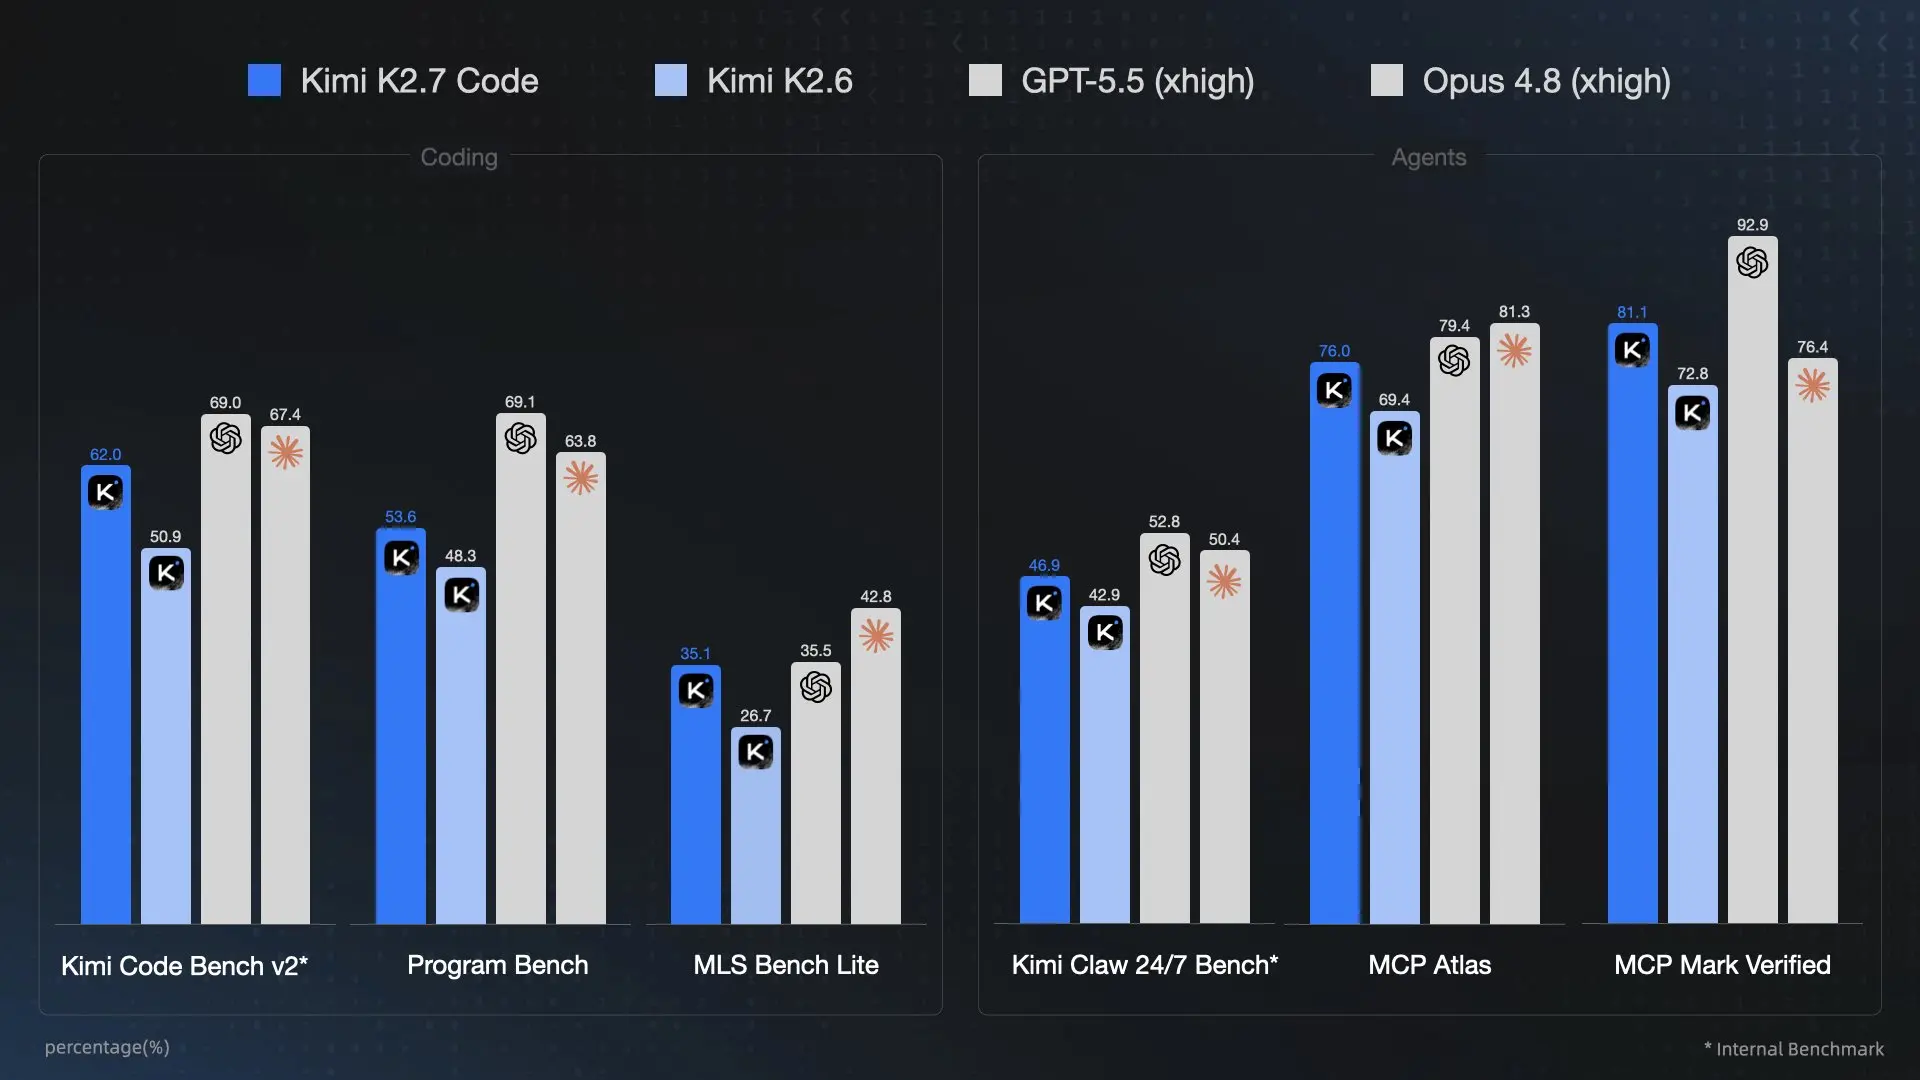
在智能体 (agent) 性能上, 该模型在 Kimi Claw 24/7 Bench 上达到 46.9, 在 MCP Atlas 上达到 76.0, 而在 MCP Mark Verified 中达到 81.1, 超越了 Claude Opus 4.8 的 76.4。
对比顶级闭源模型,Kimi-K2.7-Code 在 Kimi Code Bench v2 上的得分 (62.0) 虽仍低于 GPT-5.5(69.0) 和 Claude Opus 4.8(67.4), 但在 MCP Mark Verified 等工具调用任务中已展现出竞争力。
推理效率与长程编码优化
Kimi-K2.7-Code 重点优化了推理效率, 显著减少了过度思考 (overthinking) 现象。据厂商测试, 与 K2.6 相比, 其 reasoning-token 的使用量降低了约 30%。
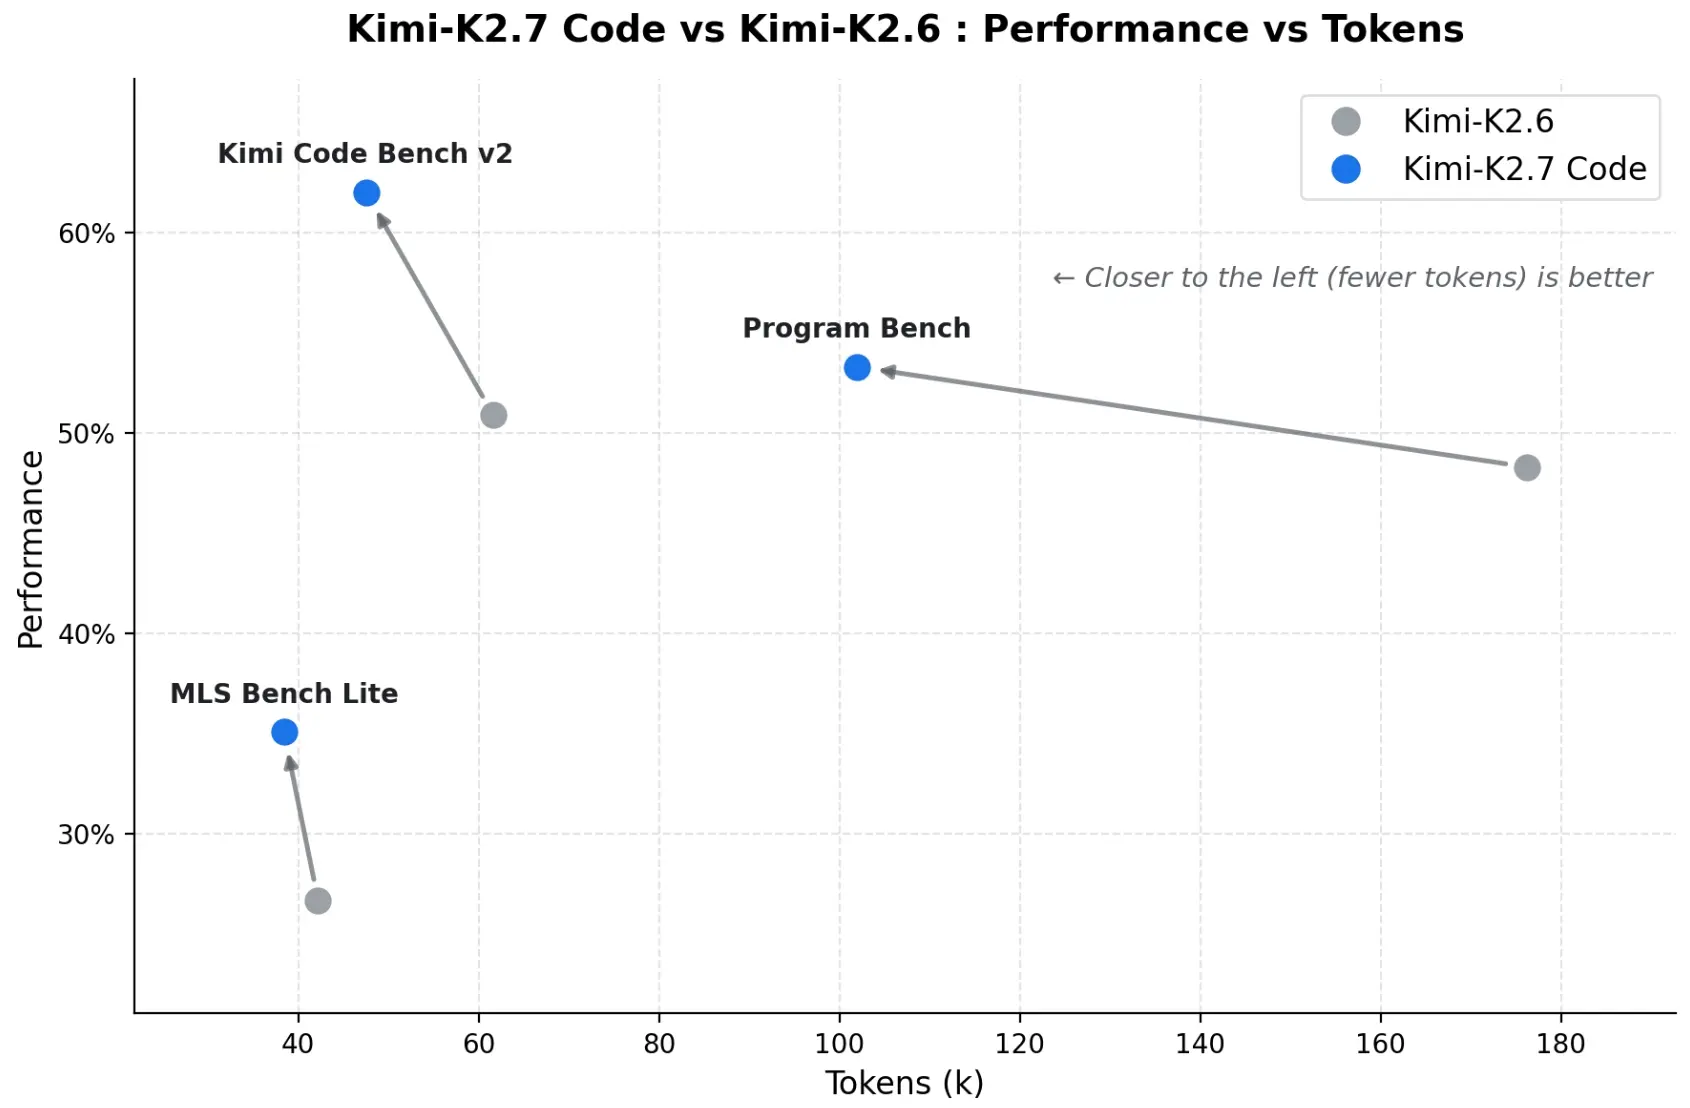
针对长程 (long-horizon) 编码任务, 该模型提升了指令遵循能力, 提高了复杂软件工程任务的端到端成功率。目前,Kimi-K2.7-Code 已通过 Kimi API 和 Kimi Code 开放使用, 官方并预告将推出 6 倍速的高速模式 (High-Speed Mode)。
Kimi-K2.7-Code 在维持 1T 总参数规模的同时, 通过优化激活参数与推理 token 效率, 使开源代码模型在复杂工程场景的实用性进一步增强。
评论 0